Stable Diffusion 3.5 ist die neueste Iteration der KI-Bilderzeugungstechnologie und bietet verbesserte Leistung, besseres Prompt-Verständnis sowie Kompatibilität mit Systemen, die nur über begrenzten Videospeicher verfügen. Dank Fortschritten bei der Modellarchitektur und den Text-Encodern ermöglicht diese Version es Kreativen, schnell und effizient hochwertige Bilder zu erzeugen. Dieser Leitfaden bietet einen ausführlichen Überblick über Stable Diffusion 3.5 Large Turbo, einschließlich seiner Funktionen, des Einrichtungsprozesses und eines praktischen Workflows mit ComfyUI.
Inhaltsverzeichnis
Was ist Stable Diffusion 3.5?
Stable Diffusion ist ein hochmodernes generatives KI-Modell, das für die Text-zu-Bild-Synthese entwickelt wurde. Die Version 3.5 führt mehrere Verbesserungen gegenüber ihren Vorgängern ein, darunter:
- Verbessertes Prompt-Verständnis:
Die Integration von T5-Text-Encodern verbessert die Fähigkeit des Modells, komplexe Prompts und Beziehungen zwischen Elementen zu interpretieren. Dadurch lassen sich leichter Bilder erzeugen, die eng mit den Beschreibungen der Nutzer übereinstimmen. - Ausgaben mit höherer Auflösung:
Stable Diffusion 3.5 erzeugt Bilder mit einer nativen Auflösung von 1024×1024, was im Vergleich zu früheren Versionen sauberere und schärfere Ergebnisse liefert. - Optimiert für Geschwindigkeit und Leistung:
Die Bezeichnung „Turbo“ zeigt an, dass dieses Modell für eine schnellere Ausführung optimiert ist, selbst auf Systemen mit begrenztem GPU-Speicher. - Modulares Design:
Im Gegensatz zu früheren Versionen sind die Text-Encoder (clip_g,clip_l, undt5xxl_fp8) nicht in der Haupt-Checkpoint-Datei enthalten. Dieser modulare Ansatz ermöglicht es den Nutzern, ihre Einrichtung an die Hardware-Beschränkungen anzupassen.
Was bedeuten FP8 und FP16?
Beim Arbeiten mit KI-Modellen wie Stable Diffusion 3.5 beziehen sich Begriffe wie FP8 und FP16 auf die Gleitkomma-Genauigkeit, die bestimmt, wie Zahlen im Modell dargestellt und verarbeitet werden. Hier eine kurze Erklärung:
- FP8 (8-Bit-Gleitkomma):
FP8 verwendet 8 Bit zur Darstellung von Zahlen. Es ist ein hocheffizientes Format, das den Speicherverbrauch und die Rechenanforderungen reduziert. Obwohl FP8 im Vergleich zu FP16 eine geringere Genauigkeit bietet, ist es ideal für Modelle, die für Geschwindigkeit optimiert sind, sowie für Hardware mit begrenzten Ressourcen, wie Stable Diffusion 3.5 Large Turbo. Dadurch ist es besonders nützlich für Systeme mit weniger Videospeicher. - FP16 (16-Bit-Gleitkomma):
FP16 verwendet 16 Bit zur Darstellung von Zahlen und bietet eine höhere Genauigkeit als FP8. Während FP16 mehr Speicher und Rechenleistung erfordert, wird es häufig in Situationen eingesetzt, in denen numerische Genauigkeit entscheidend ist, etwa beim Training großer KI-Modelle oder bei der Erzeugung sehr detaillierter Ausgaben.
Im Kontext von Stable Diffusion 3.5 nutzt der Text-Encoder T5 XXL FP8 die FP8-Genauigkeit, um Leistung und Hardware-Effizienz auszubalancieren, wodurch er für eine Vielzahl von Geräten geeignet ist.
Empfohlener GPU-Speicher für Stable Diffusion 3.5
Stable Diffusion 3.5 erfordert je nach Verwendungszweck unterschiedliche Mengen an GPU-Speicher, etwa abhängig von der Bildauflösung, der Batch-Größe und davon, ob Optimierungen angewendet werden. Hier eine kurze Zusammenfassung:
Zusammenfassung der GPU-Speicheranforderungen
- Minimum (8 GB):
- Funktioniert mit starken Optimierungen wie FP16 und xFormers.
- Geeignet für die Erzeugung von Bildern mit geringerer Auflösung (z. B. 512×512) bei einer Batch-Größe von 1.
- Einschränkungen: Kann keine hohen Auflösungen (1024×1024) oder komplexen Pipelines verarbeiten.
- Empfohlen (12–16 GB):
- Ideal für Standardauflösungen (512×512 oder 768×768) und moderate Funktionen (z. B. Inpainting, ControlNet).
- Unterstützt Batch-Größen von 1–2 und höhere Auflösungen (bis zu 1024×1024).
- Beispiele: NVIDIA RTX 3060 (12 GB), RTX 3080 (10–12 GB), RTX 4070 (12 GB).
- Optimal (16–24 GB):
- Für die Erzeugung hochauflösender Bilder (1024×1024 oder höher), erweiterte Funktionen und größere Batch-Größen (4–8 Bilder).
- Beispiele: NVIDIA RTX 3090 (24 GB), RTX 4090 (24 GB).
- Professionell (>24 GB):
- Für Forscher oder Produktionsumgebungen, die sehr hohe Auflösungen (z. B. 2048×2048), Feintuning oder das Training von Modellen erfordern.
- Beispiele: NVIDIA A100 (40 GB), H100 (80 GB).
Wo Sie die Stable Diffusion 3.5-Dateien herunterladen
Um Stable Diffusion 3.5 Large Turbo einzurichten, müssen Sie die erforderlichen Dateien aus Hugging-Face-Repositories herunterladen. Nachfolgend finden Sie die direkten Links:
1. Stable Diffusion 3.5 Large Checkpoint
- Dateiname:
sd3.5-large_turbo.safetensors - Download-Link: Stable Diffusion 3.5 Large Turbo Checkpoint
2. Text-Encoder
- Clip G Encoder:
clip_g.safetensors- Download-Link: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- Download-Link: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- Download-Link: T5 XXL FP8 Encoder
Einrichten des Stable Diffusion 3.5 Large-Checkpoints
Schritt 1: Dateien organisieren
Nachdem Sie die erforderlichen Dateien heruntergeladen haben, ordnen Sie sie wie folgt in Ihrem ComfyUI-Verzeichnis an:
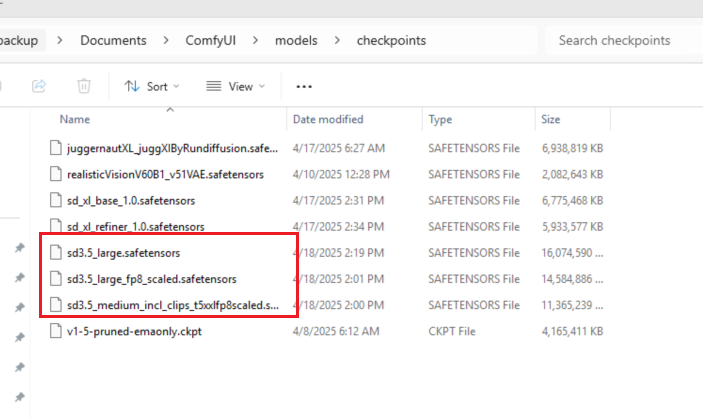
- Checkpoint-Datei:
Legen Siesd3.5-large_fp8_scaled.safetensorsin/models/checkpoints/ab.
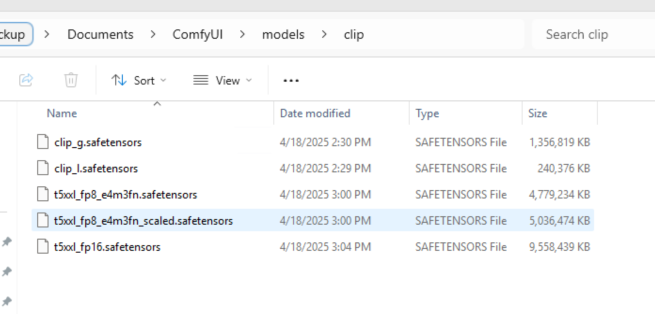
- Text-Encoder-Dateien:
Legen Sieclip_g.safetensors,clip_l.safetensors, undt5xxl_fp8_scaled.safetensorsin/models/clip/ab.
Schritt 2: ComfyUI neu starten
Starten Sie ComfyUI neu, um sicherzustellen, dass die neu hinzugefügten Dateien korrekt geladen werden.
Workflow für die Bilderzeugung
Schritt 1: Modell und Text-Encoder laden
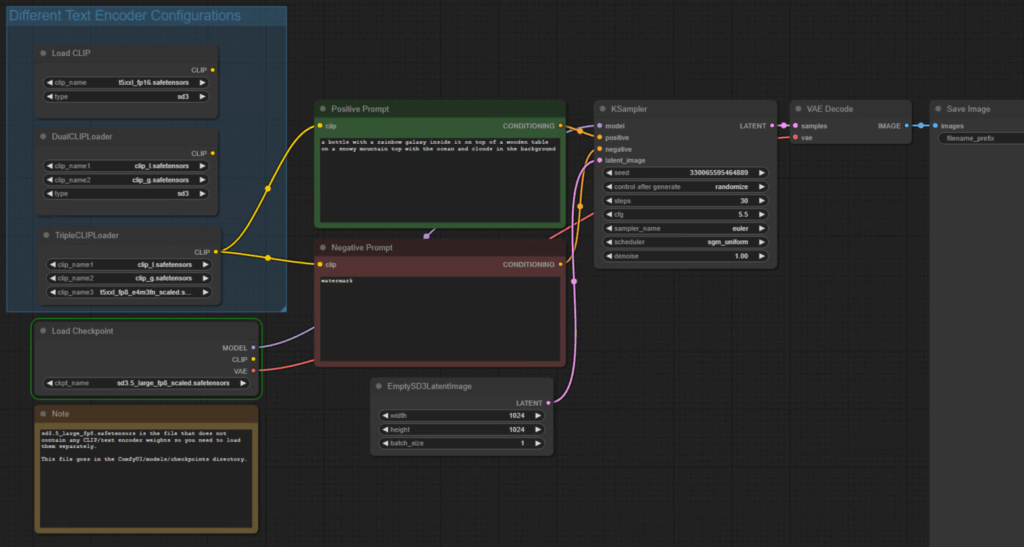
- Öffnen Sie ComfyUI und laden Sie den Workflow, der von der Website heruntergeladen wurde Comfy-Org/stable-diffusion-3.5-fp8 at main, und erstellen Sie einen TripleCLIPLoader Knoten, um die Text-Encoder zu laden (standardmäßig ist der Loader bereits vorhanden):
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- Verbinden Sie die Text-Encoder mit den Eingängen für positive und negative Prompts .
- Laden Sie das Stable Diffusion 3.5 Large-fp8-Modell (
sd3.5-large_fp8_scaled.safetensors) als Checkpoint.
Schritt 2: Anpassen der Modell-Einstellungen
Stable Diffusion 3.5 Large Turbo ist ein destilliertes Modell, das für Geschwindigkeit optimiert ist. Passen Sie die folgenden Einstellungen für optimale Ergebnisse an:
- Sampling-Schritte: Stellen Sie die Anzahl der Sampling-Schritte auf 4 ein, um die Erzeugungszeit zu verkürzen und gleichzeitig die Qualität zu erhalten.
- CFG Scale: Senken Sie die CFG-Skala (Classifier-Free Guidance) auf 1 für eine ausgewogene Bilderzeugung.
Schritt 3: Bilder erzeugen
- Geben Sie einen ausführlichen Prompt , der das fortgeschrittene Syntaxverständnis des T5-Encoders nutzt.
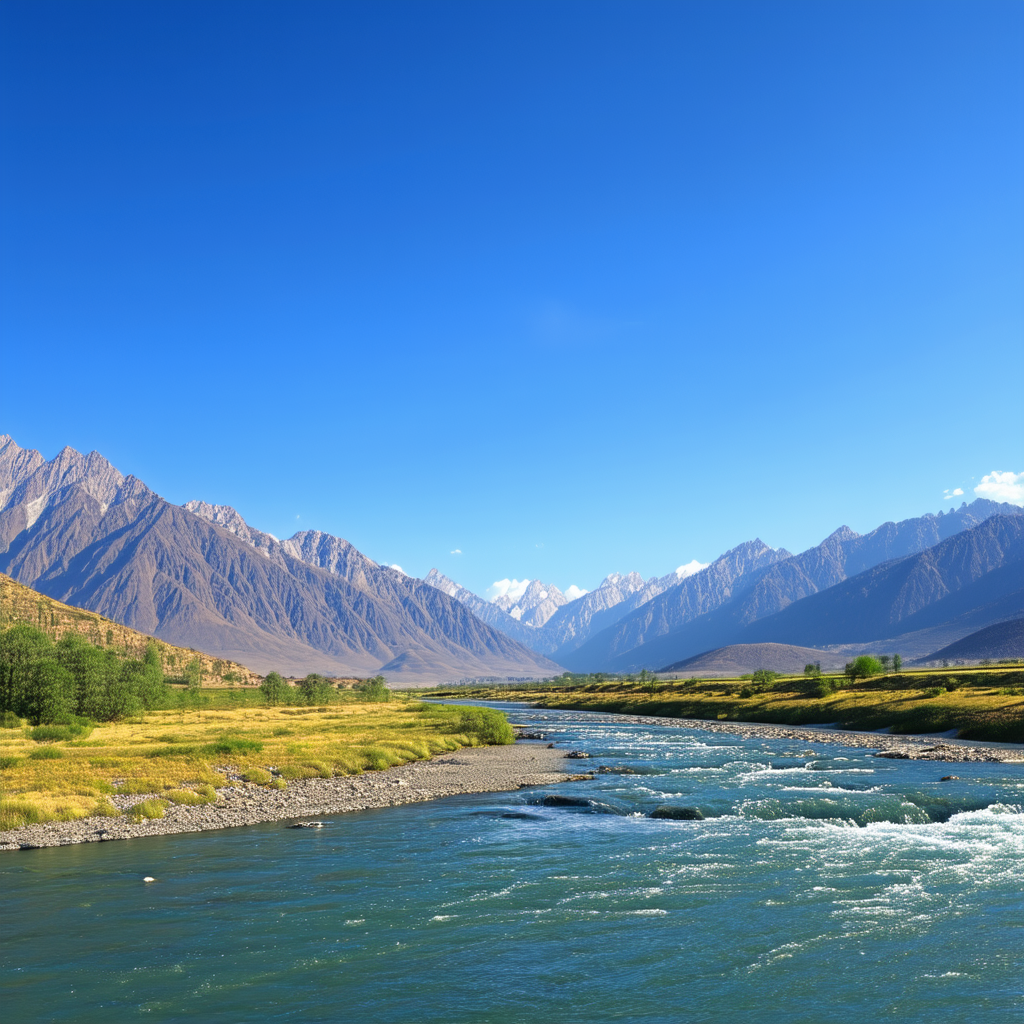
Beispiel:A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - Klicken Sie auf Queue , um den Prompt auszuführen.
- Hinweis: Die erste Bilderzeugung kann aufgrund der großen Modellgröße und der Encoder mehrere Minuten dauern. Nachfolgende Erzeugungen werden schneller sein.
Wichtige Überlegungen zu Stable Diffusion 3.5
- Prompt-Länge:
- Der T5-Encoder unterstützt bis zu 256 Tokens, was detaillierte Prompts ermöglicht.
- Der CLIP-Encoder begrenzt Prompts jedoch auf 75 Tokens, was komplexe Beschreibungen einschränken kann.
- Hardware-Anforderungen:
- Obwohl Stable Diffusion 3.5 Large Turbo für Systeme mit begrenztem Videospeicher optimiert ist, kann die anfängliche Einrichtung dennoch erheblichen Speicher erfordern, insbesondere für den T5-Encoder.
- Ausgabequalität:
- Das Modell erzeugt Bilder mit einer Auflösung von 1024×1024, was hochwertige Ergebnisse liefert, die für den professionellen Einsatz geeignet sind.
Fazit
Stable Diffusion 3.5 Large stellt einen bedeutenden Fortschritt in der KI-Bilderzeugung dar und bietet schnellere Leistung und besseres Prompt-Verständnis. Wenn Nutzer dieser Anleitung folgen, können sie das Modell mit ComfyUI effektiv einrichten und nutzen, um beeindruckende, hochauflösende Bilder zu erzeugen. Mit weiteren Verbesserungen, die in künftigen Updates erwartet werden, ist Stable Diffusion 3.5 ein leistungsstarkes Werkzeug für Kreative und Entwickler gleichermaßen.