Stable Diffusion 3.5는 AI 이미지 생성 기술의 최신 버전으로, 향상된 성능, 더 나은 프롬프트 이해, 제한된 비디오 RAM을 가진 시스템과의 호환성을 제공합니다. 모델 아키텍처와 텍스트 인코더의 발전으로 이 버전은 크리에이터가 고품질 이미지를 빠르고 효율적으로 만들 수 있게 합니다. 이 가이드는 Stable Diffusion 3.5 Large Turbo의 기능, 설정 과정, ComfyUI를 사용한 실용적인 워크플로우를 심층적으로 설명합니다.
목차
Stable Diffusion 3.5란 무엇인가요?
Stable Diffusion은 텍스트-이미지 합성을 위해 설계된 최첨단 생성형 AI 모델입니다. 3.5 버전은 이전 버전보다 여러 가지 개선 사항을 도입했으며, 그 내용은 다음과 같습니다.
- 향상된 프롬프트 이해:
T5 텍스트 인코더의 통합으로 복잡한 프롬프트와 요소 간의 관계를 해석하는 모델의 능력이 향상됩니다. 이를 통해 사용자 설명과 밀접하게 일치하는 이미지를 더 쉽게 생성할 수 있습니다. - 더 높은 해상도 출력:
Stable Diffusion 3.5는 기본 해상도 1024×1024로 이미지를 생성하여 이전 버전보다 더 깨끗하고 선명한 결과를 제공합니다. - 속도 및 성능 최적화:
“Turbo”라는 명칭은 GPU 메모리가 제한된 시스템에서도 이 모델이 더 빠른 실행을 위해 최적화되었음을 나타냅니다. - 모듈형 설계:
이전 버전과 달리 텍스트 인코더(clip_g,clip_l, 그리고t5xxl_fp8)는 기본 체크포인트 파일에 포함되어 있지 않습니다. 이러한 모듈형 접근 방식을 통해 사용자는 하드웨어 제약에 따라 설정을 맞춤화할 수 있습니다.
FP8과 FP16은 무엇을 의미하나요?
Stable Diffusion 3.5와 같은 AI 모델을 다룰 때 FP8 및 FP16과 같은 용어는 부동 소수점 정밀도를 의미하며, 이는 모델에서 숫자가 표현되고 처리되는 방식을 결정합니다. 간단히 설명하면 다음과 같습니다.
- FP8(8비트 부동 소수점):
FP8은 숫자를 표현하는 데 8비트를 사용합니다. 메모리 사용량과 계산 요구 사항을 줄이는 매우 효율적인 형식입니다. FP8은 FP16보다 정밀도가 낮지만, 속도에 최적화된 모델과 Stable Diffusion 3.5 Large Turbo와 같은 리소스가 제한된 하드웨어에 이상적입니다. 따라서 비디오 RAM이 적은 시스템에 특히 유용합니다. - FP16(16비트 부동 소수점):
FP16은 숫자를 표현하는 데 16비트를 사용하며 FP8보다 높은 정밀도를 제공합니다. FP16은 더 많은 메모리와 계산 능력을 필요로 하지만, 대규모 AI 모델 학습이나 매우 세밀한 출력 생성과 같이 수치 정확도가 중요한 상황에서 자주 사용됩니다.
Stable Diffusion 3.5의 맥락에서 텍스트 인코더 T5 XXL FP8 는 FP8 정밀도를 활용하여 성능과 하드웨어 효율성의 균형을 맞추어 다양한 장치에 적합합니다.
Stable Diffusion 3.5 실행을 위한 권장 GPU 메모리
Stable Diffusion 3.5에 필요한 GPU 메모리 양은 이미지 해상도, 배치 크기, 최적화 적용 여부 등 의도된 용도에 따라 다릅니다. 간단히 요약하면 다음과 같습니다.
GPU 메모리 요구 사항 요약
- 최소(8GB):
- FP16 및 xFormers와 같은 대대적인 최적화를 적용하면 동작합니다.
- 배치 크기 1로 저해상도 이미지(예: 512×512)를 생성하는 데 적합합니다.
- 제한 사항: 고해상도(1024×1024)나 복잡한 파이프라인은 처리할 수 없습니다.
- 권장(12–16GB):
- 표준 해상도(512×512 또는 768×768)와 보통 수준의 기능(예: 인페인팅, ControlNet)에 이상적입니다.
- 1–2의 배치 크기와 더 높은 해상도(최대 1024×1024)를 지원합니다.
- 예: NVIDIA RTX 3060(12GB), RTX 3080(10–12GB), RTX 4070(12GB).
- 최적(16–24GB):
- 고해상도 이미지(1024×1024 이상) 생성, 고급 기능, 더 큰 배치 크기(4–8개 이미지)에 적합합니다.
- 예: NVIDIA RTX 3090(24GB), RTX 4090(24GB).
- 전문가용(>24GB):
- 매우 높은 해상도(예: 2048×2048), 미세 조정, 모델 학습이 필요한 연구자나 프로덕션 환경을 위한 것입니다.
- 예: NVIDIA A100(40GB), H100(80GB).
Stable Diffusion 3.5 파일 다운로드 위치
Stable Diffusion 3.5 Large Turbo를 설정하려면 Hugging Face 리포지토리에서 필요한 파일을 다운로드해야 합니다. 직접 링크는 다음과 같습니다.
1. Stable Diffusion 3.5 Large Checkpoint
- 파일 이름:
sd3.5-large_turbo.safetensors - 다운로드 링크: Stable Diffusion 3.5 Large Turbo Checkpoint
2. 텍스트 인코더
- Clip G Encoder:
clip_g.safetensors- 다운로드 링크: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- 다운로드 링크: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- 다운로드 링크: T5 XXL FP8 Encoder
Stable Diffusion 3.5 Large 체크포인트 설정
1단계: 파일 정리
필요한 파일을 다운로드한 뒤 ComfyUI 디렉터리에 다음과 같이 정리하세요.
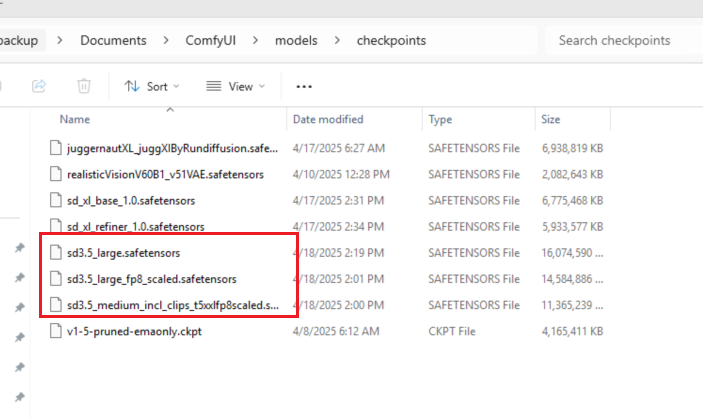
- 체크포인트 파일:
sd3.5-large_fp8_scaled.safetensors을/models/checkpoints/에 배치하세요.
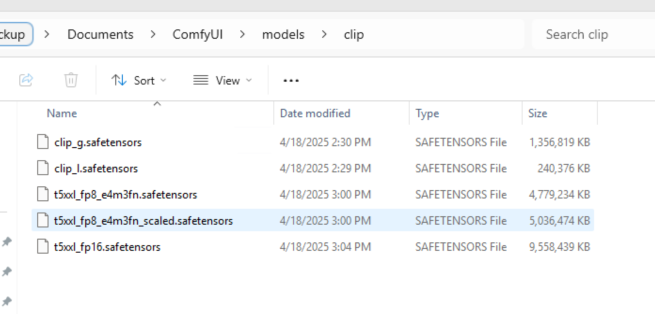
- 텍스트 인코더 파일:
clip_g.safetensors,clip_l.safetensors, 그리고t5xxl_fp8_scaled.safetensors을/models/clip/에 배치하세요.
2단계: ComfyUI 다시 시작
새로 추가한 파일이 올바르게 불러와지도록 ComfyUI를 다시 시작하세요.
이미지 생성 워크플로우
1단계: 모델 및 텍스트 인코더 불러오기
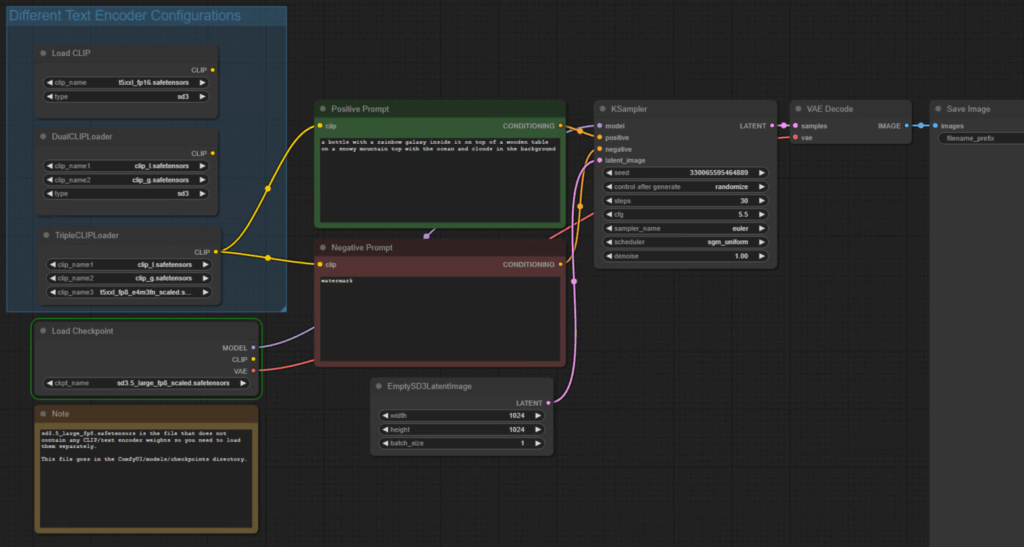
- ComfyUI를 열고 웹사이트에서 다운로드한 워크플로우를 불러온 뒤 Comfy-Org/stable-diffusion-3.5-fp8 at main TripleCLIPLoader 노드를 만들어 텍스트 인코더를 불러오세요(기본적으로 로더가 이미 존재합니다):
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- 텍스트 인코더를 긍정 과 부정 프롬프트 입력에 연결하세요.
- Stable Diffusion 3.5 Large fp8 모델(
sd3.5-large_fp8_scaled.safetensors)를 체크포인트로 불러오세요.
2단계: 모델 설정 조정
Stable Diffusion 3.5 Large Turbo는 속도에 최적화된 증류 모델입니다. 최적의 결과를 위해 다음 설정을 조정하세요.
- 샘플링 단계: 샘플링 단계 수를 4 로 설정하여 품질을 유지하면서 생성 시간을 줄이세요.
- CFG Scale: CFG(Classifier-Free Guidance) 스케일을 1 로 낮춰 균형 잡힌 이미지 생성을 하세요.
3단계: 이미지 생성
- 자세한 프롬프트 를 입력하세요. 이는 T5 인코더의 고급 구문 이해를 활용합니다.
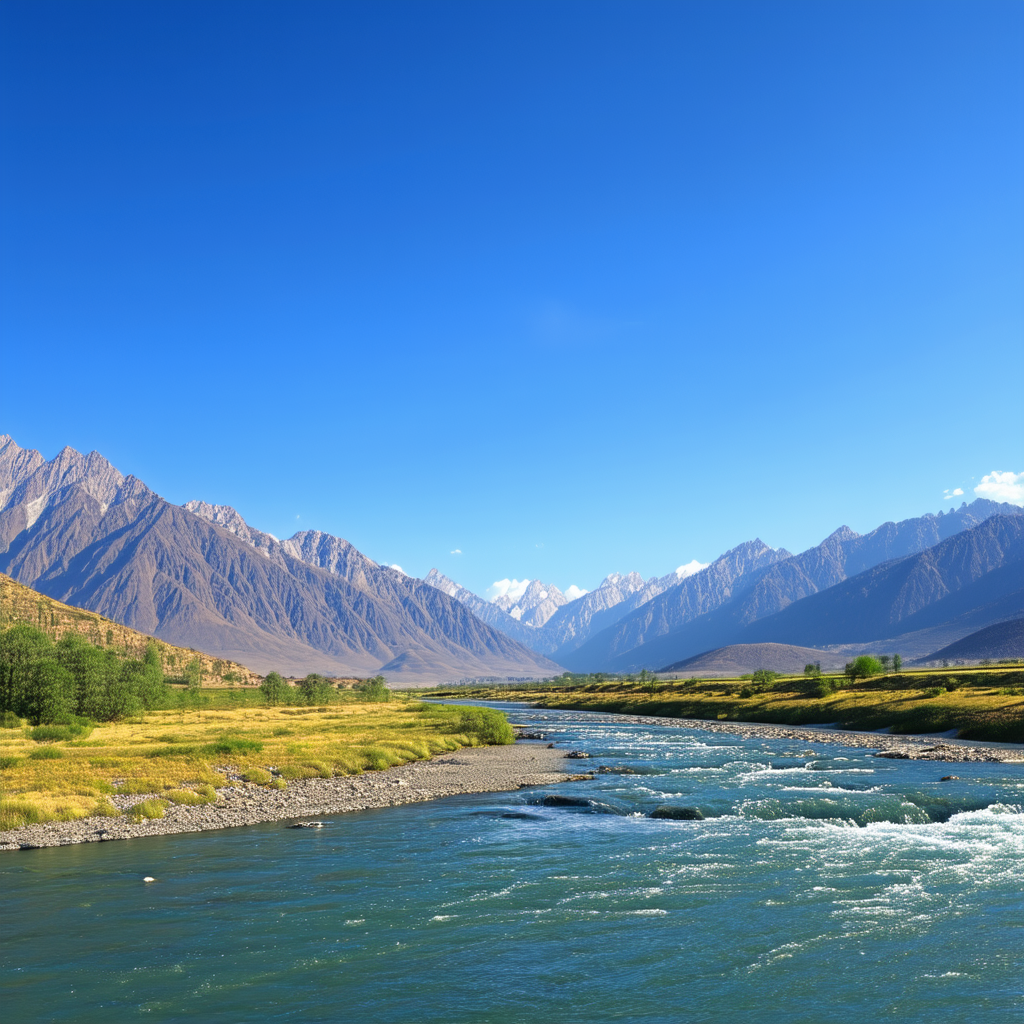
예시:A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - Queue 를 클릭하여 프롬프트를 실행하세요.
- 참고: 모델 크기가 크고 인코더가 많아 첫 이미지 생성에는 몇 분이 걸릴 수 있습니다. 이후 생성은 더 빨라집니다.
Stable Diffusion 3.5의 주요 고려 사항
- 프롬프트 길이:
- T5 인코더는 최대 256개 토큰까지 지원하므로 자세한 프롬프트를 사용할 수 있습니다.
- 그러나 CLIP 인코더는 프롬프트를 75개 토큰로 제한하므로 복잡한 설명이 제약될 수 있습니다.
- 하드웨어 요구 사항:
- Stable Diffusion 3.5 Large Turbo는 비디오 RAM이 제한된 시스템을 위해 최적화되었지만, 특히 T5 인코더의 경우 초기 설정에 여전히 상당한 메모리가 필요할 수 있습니다.
- 출력 품질:
- 모델은 1024×1024 해상도로 이미지를 생성하여 전문가용으로 적합한 고품질 결과를 제공합니다.
결론
Stable Diffusion 3.5 Large는 더 빠른 성능과 더 나은 프롬프트 이해를 제공하는 AI 이미지 생성 분야의 중요한 진전입니다. 이 가이드를 따르면 사용자는 ComfyUI를 사용하여 모델을 효과적으로 설정하고 멋진 고해상도 이미지를 만들 수 있습니다. 향후 업데이트에서 추가 개선이 예상되는 가운데, Stable Diffusion 3.5는 크리에이터와 개발자 모두에게 강력한 도구입니다.