Stable Diffusion 3.5 es la iteración más reciente de la tecnología de generación de imágenes por IA, que ofrece un rendimiento mejorado, una mejor comprensión de los prompts y compatibilidad con sistemas con poca VRAM. Con los avances en la arquitectura del modelo y los codificadores de texto, esta versión permite a los creadores producir imágenes de alta calidad de forma rápida y eficiente. Esta guía ofrece una descripción detallada de Stable Diffusion 3.5 Large Turbo, incluidas sus características, el proceso de configuración y un flujo de trabajo práctico con ComfyUI.
Tabla de contenido
¿Qué es Stable Diffusion 3.5?
Stable Diffusion es un modelo de IA generativa de vanguardia diseñado para la síntesis de texto a imagen. La versión 3.5 introduce varias mejoras respecto a sus predecesoras, entre ellas:
- Mejor comprensión de los prompts:
La integración de los codificadores de texto T5 mejora la capacidad del modelo para interpretar prompts complejos y las relaciones entre los elementos. Esto facilita la generación de imágenes que se ajustan estrechamente a las descripciones del usuario. - Salidas de mayor resolución:
Stable Diffusion 3.5 genera imágenes con una resolución nativa de 1024×1024, lo que ofrece resultados más limpios y nítidos en comparación con las versiones anteriores. - Optimizado para velocidad y rendimiento:
La denominación «Turbo» indica que este modelo está optimizado para una ejecución más rápida, incluso en sistemas con poca memoria GPU. - Diseño modular:
A diferencia de las versiones anteriores, los codificadores de texto (clip_g,clip_l, yt5xxl_fp8) no están incluidos en el archivo de checkpoint principal. Este enfoque modular permite a los usuarios personalizar su configuración según las limitaciones del hardware.
¿Qué significan FP8 y FP16?
Cuando se trabaja con modelos de IA como Stable Diffusion 3.5, términos como FP8 y FP16 se refieren a la precisión de coma flotante, que determina cómo se representan y procesan los números en el modelo. Aquí tienes una explicación rápida:
- FP8 (coma flotante de 8 bits):
FP8 usa 8 bits para representar números. Es un formato muy eficiente que reduce el uso de memoria y los requisitos computacionales. Aunque FP8 ofrece menor precisión que FP16, es ideal para modelos optimizados para la velocidad y hardware con recursos limitados, como Stable Diffusion 3.5 Large Turbo. Esto lo hace especialmente útil para sistemas con poca VRAM. - FP16 (coma flotante de 16 bits):
FP16 usa 16 bits para representar números, lo que proporciona mayor precisión que FP8. Aunque FP16 requiere más memoria y potencia computacional, se usa a menudo en situaciones en las que la precisión numérica es fundamental, como el entrenamiento de grandes modelos de IA o la generación de resultados muy detallados.
En el contexto de Stable Diffusion 3.5, el codificador de texto T5 XXL FP8 utiliza la precisión FP8 para equilibrar el rendimiento y la eficiencia del hardware, lo que lo hace adecuado para una amplia gama de dispositivos.
Memoria GPU sugerida para ejecutar Stable Diffusion 3.5
Stable Diffusion 3.5 requiere distintas cantidades de memoria GPU según el uso previsto, como la resolución de la imagen, el tamaño del lote y si se aplican optimizaciones. Aquí tienes un resumen rápido:
Resumen de los requisitos de memoria GPU
- Mínimo (8 GB):
- Funciona con optimizaciones intensivas como FP16 y xFormers.
- Adecuado para generar imágenes de menor resolución (p. ej., 512×512) con un tamaño de lote de 1.
- Limitaciones: no puede manejar resoluciones altas (1024×1024) ni pipelines complejos.
- Recomendado (12–16 GB):
- Ideal para resoluciones estándar (512×512 o 768×768) y funciones moderadas (p. ej., inpainting, ControlNet).
- Admite tamaños de lote de 1–2 y resoluciones más altas (hasta 1024×1024).
- Ejemplos: NVIDIA RTX 3060 (12 GB), RTX 3080 (10–12 GB), RTX 4070 (12 GB).
- Óptimo (16–24 GB):
- Para generar imágenes de alta resolución (1024×1024 o más), funciones avanzadas y tamaños de lote mayores (4–8 imágenes).
- Ejemplos: NVIDIA RTX 3090 (24 GB), RTX 4090 (24 GB).
- Profesional (>24 GB):
- Para investigadores o entornos de producción que requieren resoluciones muy altas (p. ej., 2048×2048), ajuste fino o entrenamiento de modelos.
- Ejemplos: NVIDIA A100 (40 GB), H100 (80 GB).
Dónde descargar los archivos de Stable Diffusion 3.5
Para configurar Stable Diffusion 3.5 Large Turbo, tendrás que descargar los archivos necesarios de los repositorios de Hugging Face. A continuación tienes los enlaces directos:
1. Stable Diffusion 3.5 Large Checkpoint
- Nombre del archivo:
sd3.5-large_turbo.safetensors - Enlace de descarga: Stable Diffusion 3.5 Large Turbo Checkpoint
2. Codificadores de texto
- Clip G Encoder:
clip_g.safetensors- Enlace de descarga: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- Enlace de descarga: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- Enlace de descarga: T5 XXL FP8 Encoder
Configuración del checkpoint Stable Diffusion 3.5 Large
Paso 1: Organizar los archivos
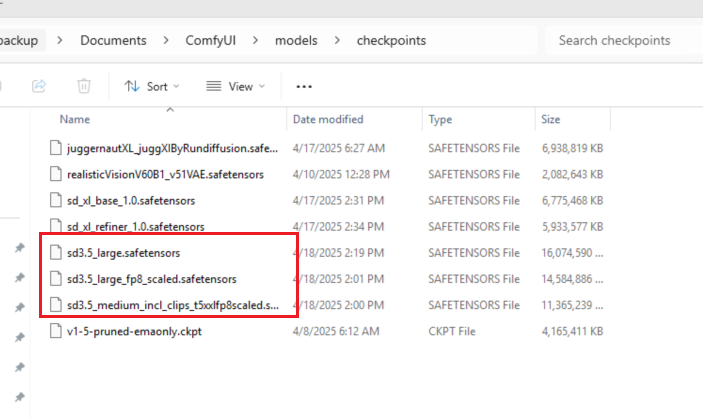
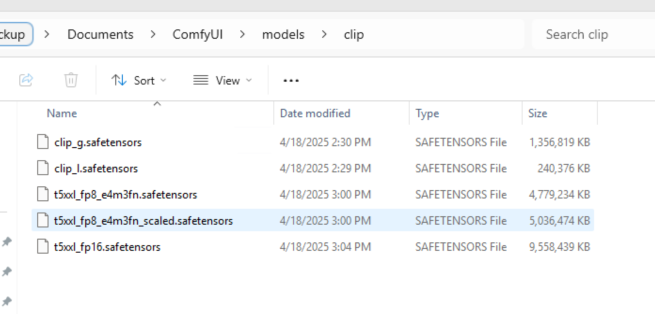
Tras descargar los archivos necesarios, organízalos en tu directorio de ComfyUI de la siguiente manera:
- Archivo de checkpoint:
Colocasd3.5-large_fp8_scaled.safetensorsen/models/checkpoints/.
- Archivos de codificadores de texto:
Colocaclip_g.safetensors,clip_l.safetensors, yt5xxl_fp8_scaled.safetensorsen/models/clip/.
Paso 2: Reiniciar ComfyUI
Reinicia ComfyUI para asegurarte de que los archivos recién añadidos se carguen correctamente.
Flujo de trabajo para la generación de imágenes
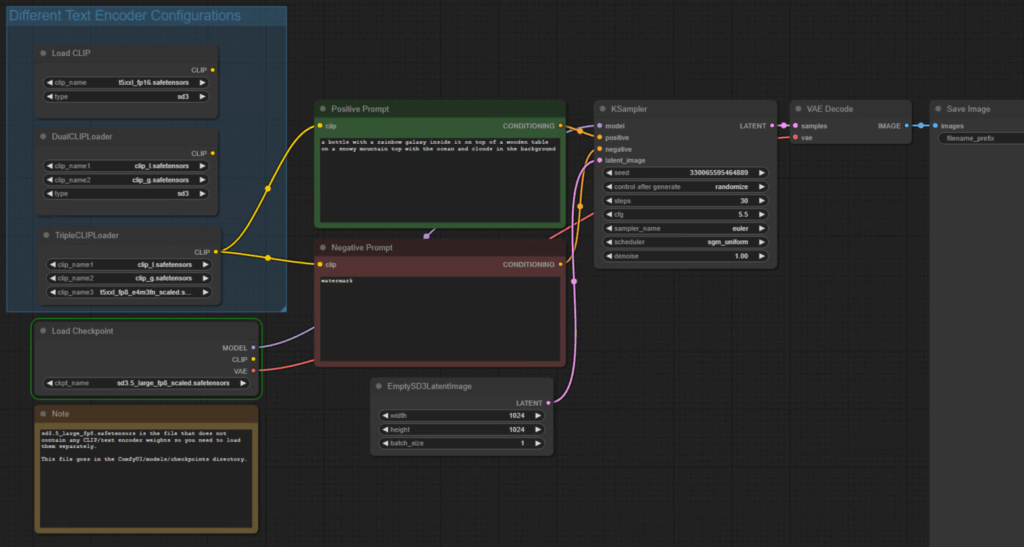
Paso 1: Cargar el modelo y los codificadores de texto
- Abre ComfyUI y carga el flujo de trabajo descargado del sitio web Comfy-Org/stable-diffusion-3.5-fp8 at main, y crea un TripleCLIPLoader nodo para cargar los codificadores de texto (de forma predeterminada, el cargador ya existe):
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- Conecta los codificadores de texto a las entradas de prompt positivo y negativo .
- Carga el modelo Stable Diffusion 3.5 Large fp8 (
sd3.5-large_fp8_scaled.safetensors) como checkpoint.
Paso 2: Ajustar la configuración del modelo
Stable Diffusion 3.5 Large Turbo es un modelo destilado, optimizado para la velocidad. Ajusta la siguiente configuración para obtener resultados óptimos:
- Pasos de muestreo: establece el número de pasos de muestreo en 4 para reducir el tiempo de generación manteniendo la calidad.
- CFG Scale: reduce la escala CFG (Classifier-Free Guidance) a 1 para una generación de imágenes equilibrada.
Paso 3: Generar imágenes
- Introduce un prompt detallado que aprovecha la comprensión sintáctica avanzada del codificador T5.
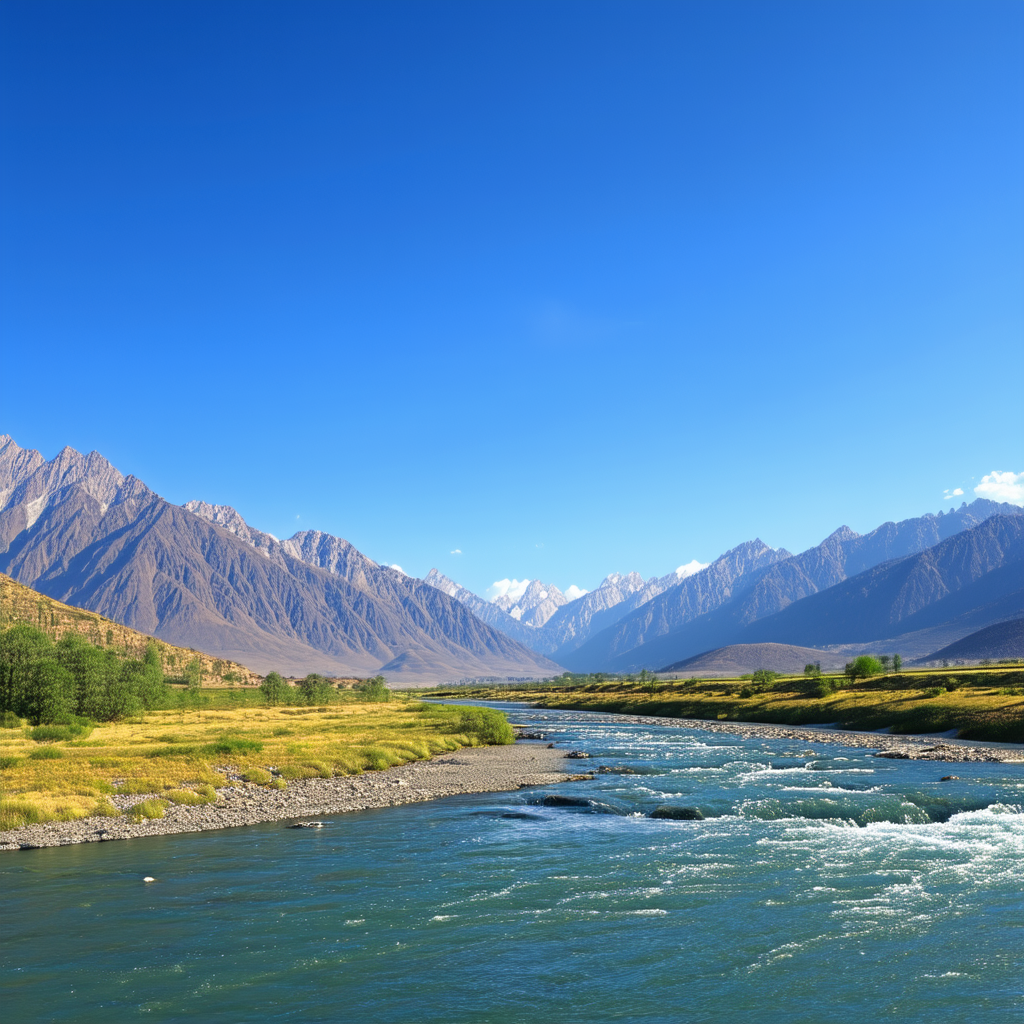
Ejemplo:A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - Haz clic en Queue para ejecutar el prompt.
- Nota: la primera generación de imágenes puede tardar varios minutos debido al gran tamaño del modelo y a los codificadores. Las generaciones posteriores serán más rápidas.
Consideraciones clave para Stable Diffusion 3.5
- Longitud del prompt:
- El codificador T5 admite hasta 256 tokens, lo que permite prompts detallados.
- Sin embargo, el codificador CLIP limita los prompts a 75 tokens, lo que puede restringir las descripciones complejas.
- Requisitos de hardware:
- Aunque Stable Diffusion 3.5 Large Turbo está optimizado para sistemas con poca VRAM, la configuración inicial puede requerir aún una cantidad considerable de memoria, especialmente para el codificador T5.
- Calidad de salida:
- El modelo genera imágenes con una resolución de 1024×1024, lo que proporciona resultados de alta calidad adecuados para uso profesional.
Conclusión
Stable Diffusion 3.5 Large representa un gran paso adelante en la generación de imágenes por IA, ya que ofrece un rendimiento más rápido y una mejor comprensión de los prompts. Siguiendo esta guía, los usuarios pueden configurar y usar el modelo de forma eficaz con ComfyUI para producir imágenes impresionantes de alta resolución. Con mejoras adicionales previstas en futuras actualizaciones, Stable Diffusion 3.5 es una herramienta potente tanto para creadores como para desarrolladores.