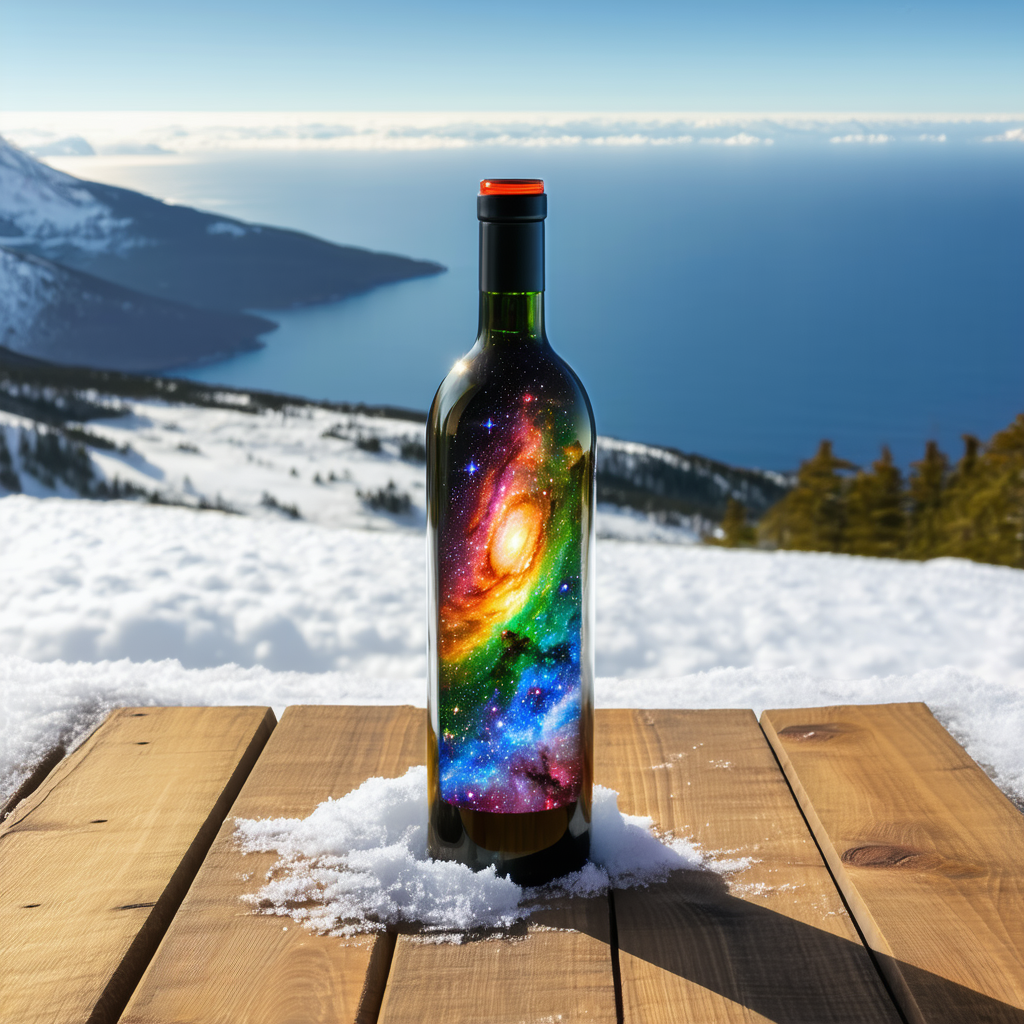
Stable Diffusion 3.5 是 AI 影像生成技術的最新版本,效能更強、提示詞理解能力更好,並相容於顯示記憶體有限的系統。隨著模型架構和文字編碼器的進步,該版本使創作者能夠快速有效地生成高品質影像。本指南深入介紹 Stable Diffusion 3.5 Large Turbo,包括其功能、設定過程以及使用 ComfyUI 的實際工作流程。
目錄
什麼是 Stable Diffusion 3.5?
Stable Diffusion 是一款為文字生成影像而設計的前沿生成式 AI 模型。3.5 版本相比前代引入了多項改進,包括:
- 提示詞理解能力提升:
T5 文字編碼器的整合增強了模型理解複雜提示詞以及元素之間關係的能力。這使得生成與使用者描述高度一致的影像變得更加容易。 - 更高解析度輸出:
Stable Diffusion 3.5 以原生解析度 1024×1024生成影像,與先前版本相比,結果更乾淨、更清晰。 - 速度與效能最佳化:
「Turbo」這一名稱表明,該模型針對更快的執行進行了最佳化,即使在 GPU 記憶體有限的系統上也是如此。 - 模組化設計:
與早期版本不同,文字編碼器(clip_g、clip_l、和t5xxl_fp8)不包含在主檢查點檔案中。這種模組化方法讓使用者可以根據硬體限制自訂設定。
FP8 和 FP16 是什麼意思?
在使用 Stable Diffusion 3.5 等 AI 模型時,FP8 和 FP16 等術語指的是 浮點精度,它決定了模型中數字的表示和處理方式。下面是簡要說明:
- FP8(8 位元浮點):
FP8 使用 8 位元來表示數字。它是一種高效的格式,可以減少記憶體占用和計算需求。儘管 FP8 的精度低於 FP16,但它非常適合針對速度最佳化的模型和資源有限的硬體,例如 Stable Diffusion 3.5 Large Turbo。這使它對顯示記憶體較低的系統特別有用。 - FP16(16 位元浮點):
FP16 使用 16 位元來表示數字,精度高於 FP8。雖然 FP16 需要更多的記憶體和計算能力,但它常用於數值精度至關重要的場景,例如訓練大型 AI 模型或生成高度精細的輸出。
在 Stable Diffusion 3.5 的語境中,文字編碼器 T5 XXL FP8 利用 FP8 精度來平衡效能和硬體效率,適用於各種裝置。
執行 Stable Diffusion 3.5 建議的 GPU 記憶體
Stable Diffusion 3.5 所需的 GPU 記憶體量因預期用途而異,例如影像解析度、批次大小以及是否應用了最佳化。下面是簡要摘要:
GPU 記憶體需求摘要
- 最低要求(8 GB):
- 在 FP16 和 xFormers 等重度最佳化下可以執行。
- 適合以批次大小 1 生成較低解析度的影像(例如 512×512)。
- 限制:無法處理高解析度(1024×1024)或複雜流程。
- 建議組態(12–16 GB):
- 適合標準解析度(512×512 或 768×768)和中等功能(例如修復、ControlNet)。
- 支援 1–2 的批次大小和更高解析度(最高 1024×1024)。
- 例如:NVIDIA RTX 3060(12 GB)、RTX 3080(10–12 GB)、RTX 4070(12 GB)。
- 最佳組態(16–24 GB):
- 用於生成高解析度影像(1024×1024 或更高)、進階功能和更大的批次大小(4–8 張影像)。
- 例如:NVIDIA RTX 3090(24 GB)、RTX 4090(24 GB)。
- 專業級 (>24 GB):
- 適用於需要非常高解析度(例如 2048×2048)、微調或訓練模型的研究人員或生產環境。
- 例如:NVIDIA A100(40 GB)、H100(80 GB)。
Stable Diffusion 3.5 檔案下載位置
要設定 Stable Diffusion 3.5 Large Turbo,您需要從 Hugging Face 儲存庫下載所需檔案。以下是直接連結:
1. Stable Diffusion 3.5 Large Checkpoint
- 檔案名稱:
sd3.5-large_turbo.safetensors - 下載連結: Stable Diffusion 3.5 Large Turbo Checkpoint
2. 文字編碼器
- Clip G Encoder:
clip_g.safetensors- 下載連結: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- 下載連結: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- 下載連結: T5 XXL FP8 Encoder
設定 Stable Diffusion 3.5 Large 檢查點
第 1 步:整理檔案
下載所需檔案後,請按如下方式將它們整理到 ComfyUI 目錄中:
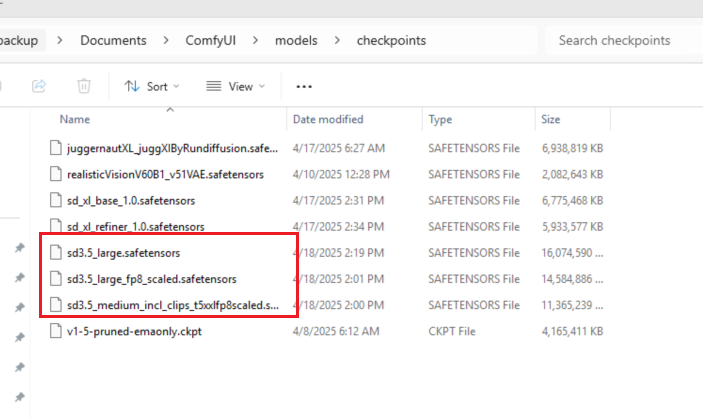
- 檢查點檔案:
將sd3.5-large_fp8_scaled.safetensors放入/models/checkpoints/。
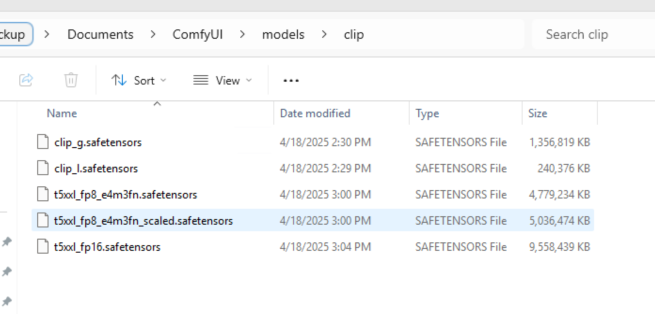
- 文字編碼器檔案:
將clip_g.safetensors、clip_l.safetensors、和t5xxl_fp8_scaled.safetensors放入/models/clip/。
第 2 步:重新啟動 ComfyUI
重新啟動 ComfyUI,以確保新加入的檔案正確載入。
影像生成工作流程
第 1 步:載入模型和文字編碼器
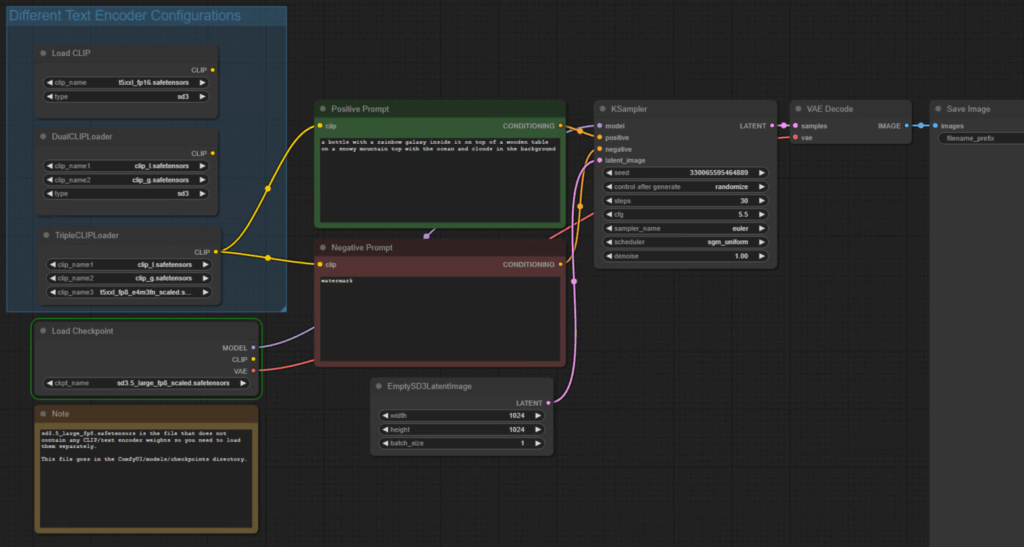
- 開啟 ComfyUI 並載入從網站下載的工作流程 Comfy-Org/stable-diffusion-3.5-fp8 at main,並建立 TripleCLIPLoader 節點來載入文字編碼器(預設情況下載入器已存在):
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- 將文字編碼器連接到 正面 和 負面提示詞 輸入。
- 載入 Stable Diffusion 3.5 Large fp8 模型(
sd3.5-large_fp8_scaled.safetensors)作為檢查點。
第 2 步:調整模型設定
Stable Diffusion 3.5 Large Turbo 是一個為速度最佳化的蒸餾模型。請調整以下設定以獲得最佳結果:
- 取樣步數:將取樣步數設定為 4 ,以減少生成時間,同時保持品質。
- CFG Scale:將 CFG(無分類器引導)縮放比例降低到 1 ,以實現均衡的影像生成。
第 3 步:生成影像
- 輸入一個 詳細提示詞 ,它利用了 T5 編碼器先進的語法理解能力。
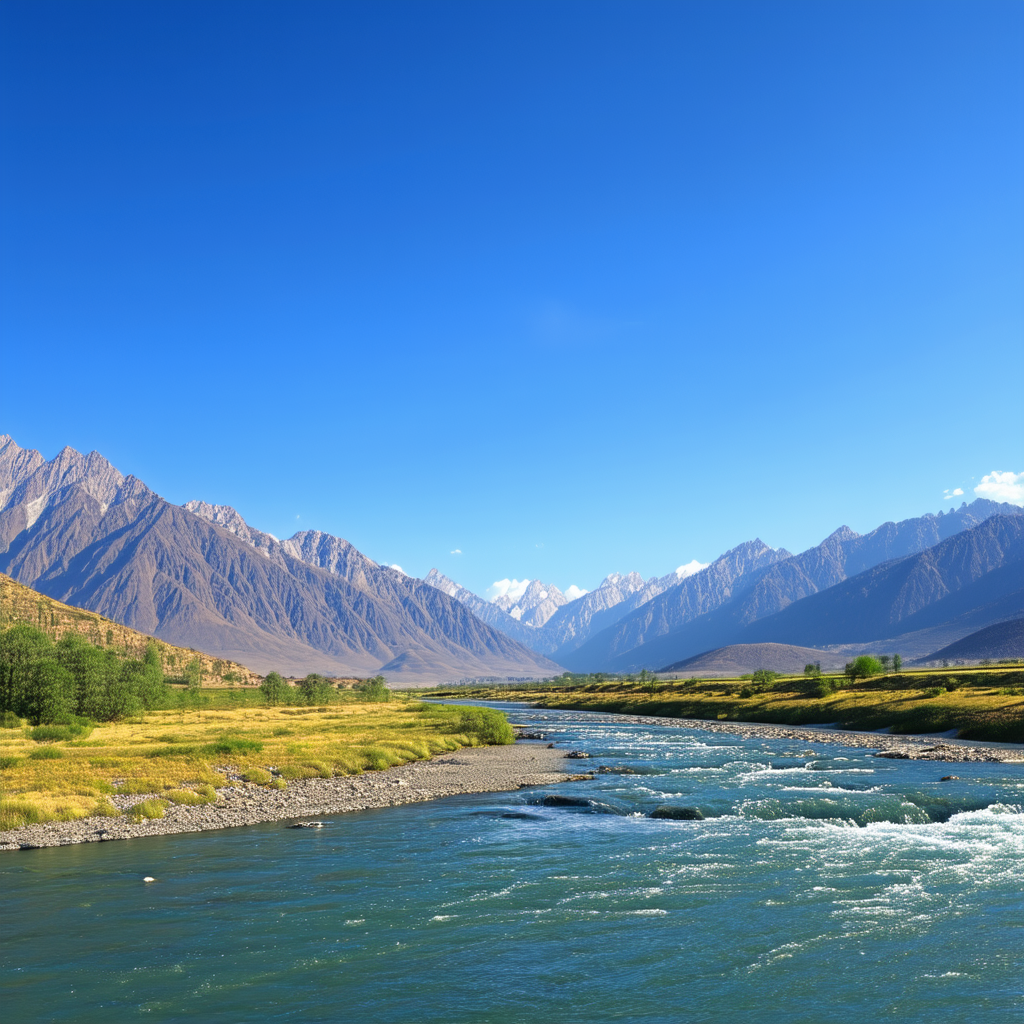
範例:A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - 點擊 Queue 以執行提示詞。
- 注意:由於模型體積大、編碼器多,首次生成影像可能需要幾分鐘。後續生成會更快。
Stable Diffusion 3.5 的關鍵注意事項
- 提示詞長度:
- T5 編碼器最多支援 256 個詞元,從而可以使用詳細的提示詞。
- 然而,CLIP 編碼器將提示詞限制在 75 個詞元,這可能會限制複雜的描述。
- 硬體要求:
- 雖然 Stable Diffusion 3.5 Large Turbo 針對顯示記憶體有限的系統進行了最佳化,但初始設定仍可能需要大量記憶體,尤其是 T5 編碼器。
- 輸出品質:
- 該模型以 1024×1024 解析度生成影像,提供適合專業用途的高品質結果。
結論
Stable Diffusion 3.5 Large 是 AI 影像生成領域的一大進步,效能更快、提示詞理解能力更好。按照本指南,使用者可以使用 ComfyUI 有效地設定和使用該模型,生成令人驚嘆的高解析度影像。隨著未來更新中預計的進一步改進,Stable Diffusion 3.5 對創作者和開發者來說都是一個強大的工具。