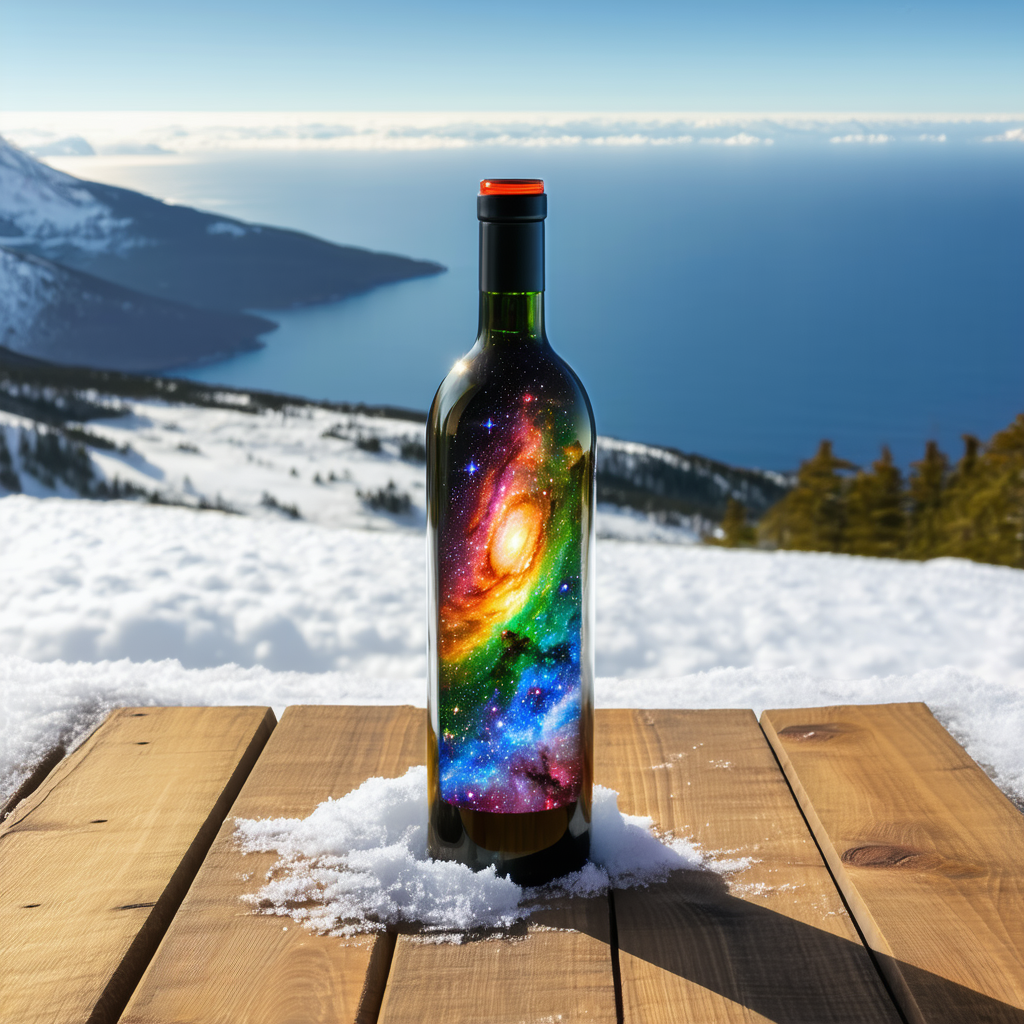
Stable Diffusion 3.5 は、AI 画像生成技術の最新版であり、パフォーマンスの向上、プロンプト理解の改善、ビデオ RAM が限られたシステムとの互換性を提供します。モデルアーキテクチャとテキストエンコーダーの進歩により、このバージョンではクリエイターが高品質な画像を迅速かつ効率的に生成できます。このガイドでは、Stable Diffusion 3.5 Large Turbo の機能、セットアッププロセス、ComfyUI を使用した実践的なワークフローを詳しく説明します。
目次
Stable Diffusion 3.5 とは?
Stable Diffusion は、テキストから画像への合成のために設計された最先端の生成 AI モデルです。バージョン 3.5 では、前バージョンに比べていくつかの改善が導入されています。以下にその内容を示します。
- プロンプト理解の向上:
T5 テキストエンコーダーの統合により、複雑なプロンプトや要素間の関係を解釈するモデルの能力が向上します。これにより、ユーザーの説明に密接に合致した画像を生成しやすくなります。 - 高解像度出力:
Stable Diffusion 3.5 は、ネイティブ解像度 1024×1024で画像を生成し、以前のバージョンと比べてよりクリーンでシャープな結果をもたらします。 - 速度とパフォーマンスの最適化:
「Turbo」という名称は、GPU メモリが限られたシステムでも、このモデルが高速な実行のために最適化されていることを示しています。 - モジュラー設計:
以前のバージョンとは異なり、テキストエンコーダー(clip_g、clip_l、およびt5xxl_fp8)はメインのチェックポイントファイルに含まれていません。このモジュラーアプローチにより、ユーザーはハードウェアの制約に基づいてセットアップをカスタマイズできます。
FP8 と FP16 とは何を意味しますか?
Stable Diffusion 3.5 のような AI モデルを扱う際、FP8 や FP16 といった用語は 浮動小数点精度を指します。これは、モデル内で数値がどのように表現され、処理されるかを決定します。以下に簡単な説明を示します。
- FP8(8 ビット浮動小数点):
FP8 は、数値を表すのに 8 ビットを使用します。これはメモリ使用量と計算要件を削減する、非常に効率的な形式です。FP8 は FP16 と比べて精度は低くなりますが、速度に最適化されたモデルや、Stable Diffusion 3.5 Large Turbo のようなリソースが限られたハードウェアに最適です。そのため、ビデオ RAM の少ないシステムに特に有用です。 - FP16(16 ビット浮動小数点):
FP16 は、数値を表すのに 16 ビットを使用し、FP8 よりも高い精度を提供します。FP16 はより多くのメモリと計算能力を必要としますが、大規模な AI モデルのトレーニングや非常に詳細な出力の生成など、数値精度が重要な場面でよく使用されます。
Stable Diffusion 3.5 の文脈では、テキストエンコーダー T5 XXL FP8 は、FP8 精度を利用してパフォーマンスとハードウェア効率のバランスを取り、幅広いデバイスに適しています。
Stable Diffusion 3.5 を実行するための推奨 GPU メモリ
Stable Diffusion 3.5 に必要な GPU メモリの量は、画像解像度、バッチサイズ、最適化の適用有無など、想定される用途によって異なります。以下に簡単な概要を示します。
GPU メモリ要件の概要
- 最小(8 GB):
- FP16 や xFormers のような大規模な最適化と併用することで動作します。
- バッチサイズ 1 で低解像度の画像(例:512×512)を生成するのに適しています。
- 制限:高解像度(1024×1024)や複雑なパイプラインには対応できません。
- 推奨(12–16 GB):
- 標準解像度(512×512 または 768×768)や中程度の機能(例:インペインティング、ControlNet)に最適です。
- バッチサイズ 1~2 と、より高い解像度(最大 1024×1024)に対応します。
- 例:NVIDIA RTX 3060(12 GB)、RTX 3080(10–12 GB)、RTX 4070(12 GB)。
- 最適(16–24 GB):
- 高解像度画像(1024×1024 以上)の生成、高度な機能、より大きなバッチサイズ(4~8 枚の画像)に適しています。
- 例:NVIDIA RTX 3090(24 GB)、RTX 4090(24 GB)。
- プロフェッショナル(>24 GB):
- 非常に高い解像度(例:2048×2048)、ファインチューニング、またはモデルのトレーニングを必要とする研究者や本番環境向けです。
- 例:NVIDIA A100(40 GB)、H100(80 GB)。
Stable Diffusion 3.5 ファイルのダウンロード場所
Stable Diffusion 3.5 Large Turbo をセットアップするには、Hugging Face リポジトリから必要なファイルをダウンロードする必要があります。以下に直接リンクを示します。
1. Stable Diffusion 3.5 Large Checkpoint
- ファイル名:
sd3.5-large_turbo.safetensors - ダウンロードリンク: Stable Diffusion 3.5 Large Turbo Checkpoint
2. テキストエンコーダー
- Clip G Encoder:
clip_g.safetensors- ダウンロードリンク: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- ダウンロードリンク: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- ダウンロードリンク: T5 XXL FP8 Encoder
Stable Diffusion 3.5 Large チェックポイントのセットアップ
ステップ 1:ファイルの整理
必要なファイルをダウンロードしたら、ComfyUI ディレクトリ内に次のように整理します。
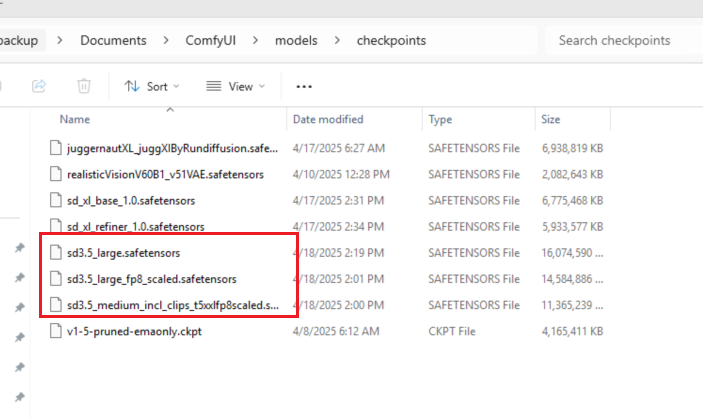
- チェックポイントファイル:
sd3.5-large_fp8_scaled.safetensorsを/models/checkpoints/に配置します。
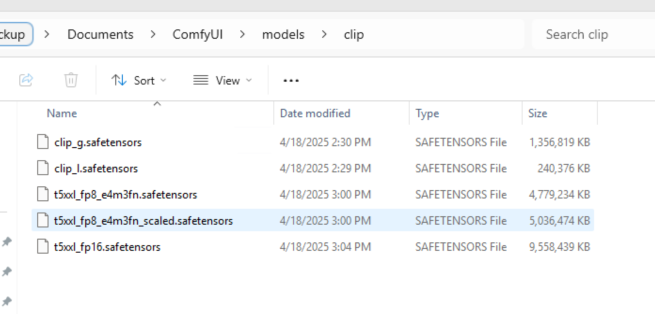
- テキストエンコーダーファイル:
clip_g.safetensors、clip_l.safetensors、およびt5xxl_fp8_scaled.safetensorsを/models/clip/に配置します。
ステップ 2:ComfyUI の再起動
新しく追加したファイルが正しく読み込まれるように、ComfyUI を再起動します。
画像生成のワークフロー
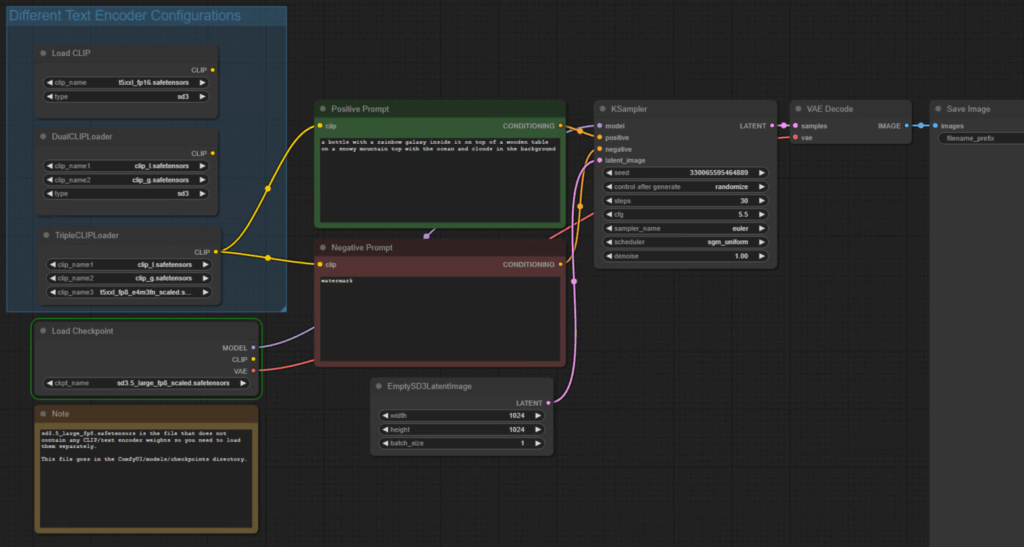
ステップ 1:モデルとテキストエンコーダーの読み込み
- ComfyUI を開き、Web サイトからダウンロードしたワークフローを読み込み、 Comfy-Org/stable-diffusion-3.5-fp8 at main TripleCLIPLoader ノードを作成して、テキストエンコーダーを読み込みます(既定では、ローダーは既に存在します):
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- テキストエンコーダーを ポジティブ と ネガティブプロンプト 入力に接続します。
- Stable Diffusion 3.5 Large fp8 モデル(
sd3.5-large_fp8_scaled.safetensors)をチェックポイントとして読み込みます。
ステップ 2:モデル設定の調整
Stable Diffusion 3.5 Large Turbo は、速度に最適化された蒸留モデルです。最適な結果を得るために、次の設定を調整します。
- サンプリングステップ:サンプリングステップ数を 4 に設定し、品質を維持しながら生成時間を短縮します。
- CFG Scale:CFG(Classifier-Free Guidance)スケールを 1 まで下げ、バランスの取れた画像生成を実現します。
ステップ 3:画像の生成
- 詳細なプロンプト を入力し、T5 エンコーダーの高度な構文理解を活用します。
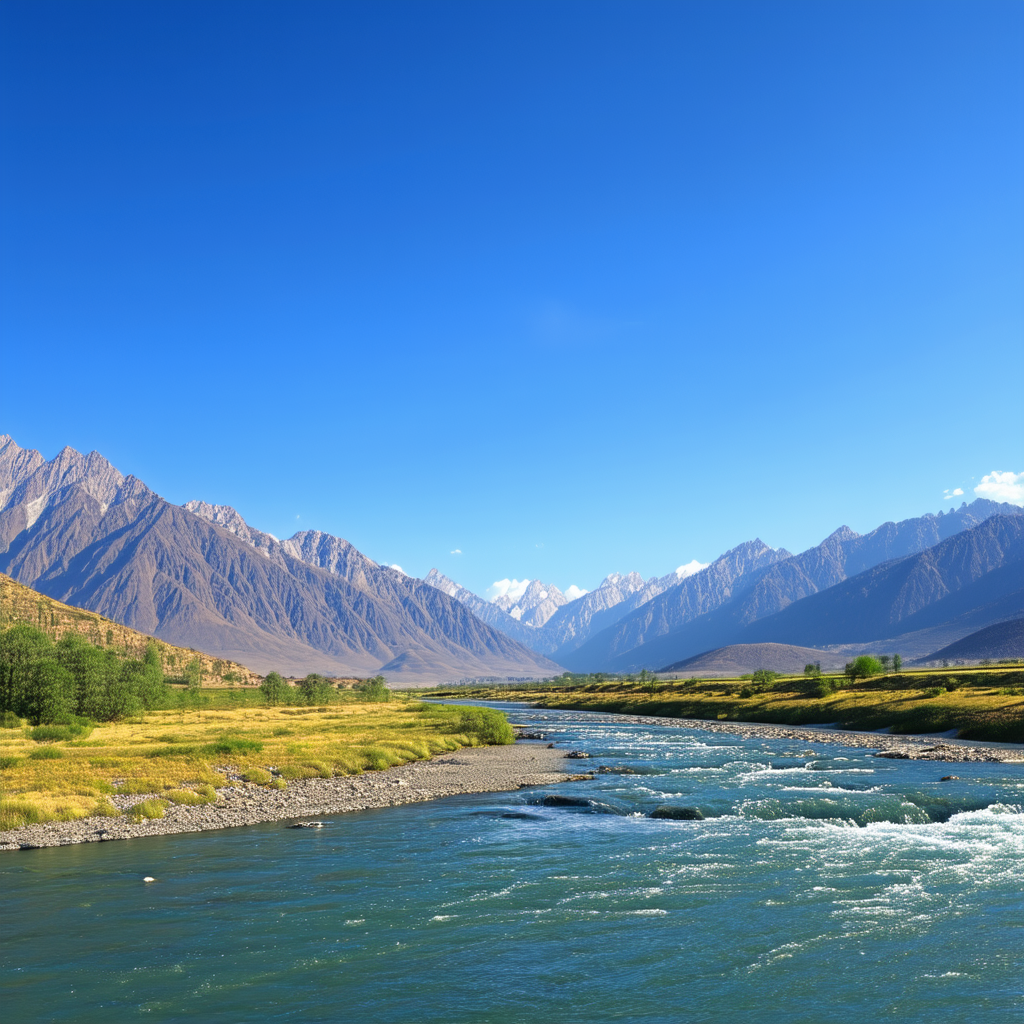
例:A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - Queue をクリックして、プロンプトを実行します。
- 注:モデルのサイズが大きく、エンコーダーも多いため、最初の画像生成には数分かかる場合があります。その後の生成はより高速になります。
Stable Diffusion 3.5 の主な考慮事項
- プロンプトの長さ:
- T5 エンコーダーは最大で 256 トークンまで対応し、詳細なプロンプトを使用できます。
- ただし、CLIP エンコーダーはプロンプトを 75 トークンまでに制限するため、複雑な説明が制約される場合があります。
- ハードウェア要件:
- Stable Diffusion 3.5 Large Turbo はビデオ RAM が限られたシステム向けに最適化されていますが、特に T5 エンコーダーでは、初期セットアップに依然としてかなりのメモリが必要になる場合があります。
- 出力品質:
- モデルは 1024×1024 の解像度で画像を生成し、プロフェッショナルな用途に適した高品質な結果を提供します。
結論
Stable Diffusion 3.5 Large は、AI 画像生成における大きな前進であり、より高速なパフォーマンスと優れたプロンプト理解を提供します。このガイドに従うことで、ユーザーは ComfyUI を使ってモデルを効果的にセットアップし、見事な高解像度画像を生成できます。今後のアップデートでさらなる改良が期待される中、Stable Diffusion 3.5 はクリエイターと開発者の双方にとって強力なツールです。