Stable Diffusion 3.5 AI छवि निर्माण तकनीक का नवीनतम संस्करण है, जो बेहतर प्रदर्शन, बेहतर प्रॉम्प्ट समझ और सीमित वीडियो RAM वाले सिस्टम के साथ संगतता प्रदान करता है। मॉडल आर्किटेक्चर और टेक्स्ट एन्कोडर में हुई प्रगति के साथ, यह संस्करण रचनाकारों को उच्च-गुणवत्ता वाली छवियाँ जल्दी और कुशलता से बनाने में सक्षम बनाता है। यह मार्गदर्शिका Stable Diffusion 3.5 Large Turbo का गहन अवलोकन प्रदान करती है, जिसमें इसकी विशेषताएँ, सेटअप प्रक्रिया और ComfyUI का उपयोग करके व्यावहारिक वर्कफ़्लो शामिल है।
विषय-सूची
Stable Diffusion 3.5 क्या है?
Stable Diffusion टेक्स्ट-टू-इमेज संश्लेषण के लिए डिज़ाइन किया गया एक अत्याधुनिक जनरेटिव AI मॉडल है। 3.5 संस्करण अपने पूर्ववर्तियों की तुलना में कई सुधार लाता है, जिनमें शामिल हैं:
- बेहतर प्रॉम्प्ट समझ:
T5 टेक्स्ट एन्कोडर का एकीकरण जटिल प्रॉम्प्ट और तत्वों के बीच संबंधों की व्याख्या करने की मॉडल की क्षमता को बढ़ाता है। इससे उपयोगकर्ता के विवरणों से निकटता से मेल खाने वाली छवियाँ बनाना आसान हो जाता है। - उच्च रिज़ॉल्यूशन आउटपुट:
Stable Diffusion 3.5 मूल रिज़ॉल्यूशन 1024×1024 पर छवियाँ बनाता है, जिससे पिछले संस्करणों की तुलना में अधिक साफ़ और तीक्ष्ण परिणाम मिलते हैं। - गति और प्रदर्शन के लिए अनुकूलित:
“Turbo” नाम इंगित करता है कि यह मॉडल सीमित GPU मेमोरी वाले सिस्टम पर भी तेज़ निष्पादन के लिए अनुकूलित है। - मॉड्यूलर डिज़ाइन:
पहले के संस्करणों के विपरीत, टेक्स्ट एन्कोडर (clip_g,clip_l, औरt5xxl_fp8) मुख्य चेकपॉइंट फ़ाइल में शामिल नहीं हैं। यह मॉड्यूलर दृष्टिकोण उपयोगकर्ताओं को हार्डवेयर बाधाओं के आधार पर अपना सेटअप अनुकूलित करने देता है।
FP8 और FP16 का क्या अर्थ है?
Stable Diffusion 3.5 जैसे AI मॉडल के साथ काम करते समय, FP8 और FP16 जैसे शब्द फ़्लोटिंग-पॉइंट परिशुद्धता को संदर्भित करते हैं, जो यह निर्धारित करती है कि मॉडल में संख्याओं को कैसे दर्शाया और संसाधित किया जाता है। यहाँ एक त्वरित व्याख्या है:
- FP8 (फ़्लोटिंग पॉइंट 8-बिट):
FP8 संख्याओं को दर्शाने के लिए 8 बिट का उपयोग करता है। यह एक अत्यधिक कुशल प्रारूप है जो मेमोरी उपयोग और कम्प्यूटेशनल आवश्यकताओं को कम करता है। हालाँकि FP8, FP16 की तुलना में कम परिशुद्धता प्रदान करता है, यह गति के लिए अनुकूलित मॉडल और सीमित संसाधनों वाले हार्डवेयर, जैसे Stable Diffusion 3.5 Large Turbo, के लिए आदर्श है। यह इसे कम वीडियो RAM वाले सिस्टम के लिए विशेष रूप से उपयोगी बनाता है। - FP16 (फ़्लोटिंग पॉइंट 16-बिट):
FP16 संख्याओं को दर्शाने के लिए 16 बिट का उपयोग करता है, जो FP8 की तुलना में उच्च परिशुद्धता प्रदान करता है। हालाँकि FP16 को अधिक मेमोरी और कम्प्यूटेशनल शक्ति की आवश्यकता होती है, इसका उपयोग अक्सर उन स्थितियों में किया जाता है जहाँ संख्यात्मक सटीकता महत्वपूर्ण होती है, जैसे बड़े AI मॉडल को प्रशिक्षित करना या अत्यधिक विस्तृत आउटपुट बनाना।
Stable Diffusion 3.5 के संदर्भ में, टेक्स्ट एन्कोडर T5 XXL FP8 प्रदर्शन और हार्डवेयर दक्षता को संतुलित करने के लिए FP8 परिशुद्धता का उपयोग करता है, जिससे यह कई प्रकार के उपकरणों के लिए उपयुक्त है।
Stable Diffusion 3.5 चलाने के लिए सुझाई गई GPU मेमोरी
Stable Diffusion 3.5 को इच्छित उपयोग के आधार पर अलग-अलग मात्रा में GPU मेमोरी की आवश्यकता होती है, जैसे छवि रिज़ॉल्यूशन, बैच आकार, और क्या अनुकूलन लागू किए गए हैं। यहाँ एक त्वरित सारांश है:
GPU मेमोरी आवश्यकताओं का सारांश
- न्यूनतम (8 GB):
- FP16 और xFormers जैसे भारी अनुकूलन के साथ काम करता है।
- बैच आकार 1 के साथ कम रिज़ॉल्यूशन वाली छवियाँ (जैसे, 512×512) बनाने के लिए उपयुक्त है।
- सीमाएँ: उच्च रिज़ॉल्यूशन (1024×1024) या जटिल पाइपलाइन को संभाल नहीं सकता।
- अनुशंसित (12–16 GB):
- मानक रिज़ॉल्यूशन (512×512 या 768×768) और मध्यम सुविधाओं (जैसे, इनपेंटिंग, ControlNet) के लिए आदर्श है।
- 1–2 के बैच आकार और उच्च रिज़ॉल्यूशन (1024×1024 तक) का समर्थन करता है।
- उदाहरण: NVIDIA RTX 3060 (12 GB), RTX 3080 (10–12 GB), RTX 4070 (12 GB)।
- इष्टतम (16–24 GB):
- उच्च-रिज़ॉल्यूशन छवियाँ (1024×1024 या अधिक), उन्नत सुविधाएँ, और बड़े बैच आकार (4–8 छवियाँ) बनाने के लिए।
- उदाहरण: NVIDIA RTX 3090 (24 GB), RTX 4090 (24 GB)।
- पेशेवर (>24 GB):
- बहुत उच्च रिज़ॉल्यूशन (जैसे, 2048×2048), फ़ाइन-ट्यूनिंग, या मॉडल प्रशिक्षण की आवश्यकता वाले शोधकर्ताओं या उत्पादन वातावरण के लिए।
- उदाहरण: NVIDIA A100 (40 GB), H100 (80 GB)।
Stable Diffusion 3.5 फ़ाइलें कहाँ से डाउनलोड करें
Stable Diffusion 3.5 Large Turbo सेट करने के लिए, आपको Hugging Face रिपॉज़िटरी से आवश्यक फ़ाइलें डाउनलोड करनी होंगी। नीचे सीधे लिंक दिए गए हैं:
1. Stable Diffusion 3.5 Large Checkpoint
- फ़ाइल नाम:
sd3.5-large_turbo.safetensors - डाउनलोड लिंक: Stable Diffusion 3.5 Large Turbo Checkpoint
2. टेक्स्ट एन्कोडर
- Clip G Encoder:
clip_g.safetensors- डाउनलोड लिंक: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- डाउनलोड लिंक: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- डाउनलोड लिंक: T5 XXL FP8 Encoder
Stable Diffusion 3.5 Large चेकपॉइंट सेट करना
चरण 1: फ़ाइलें व्यवस्थित करना
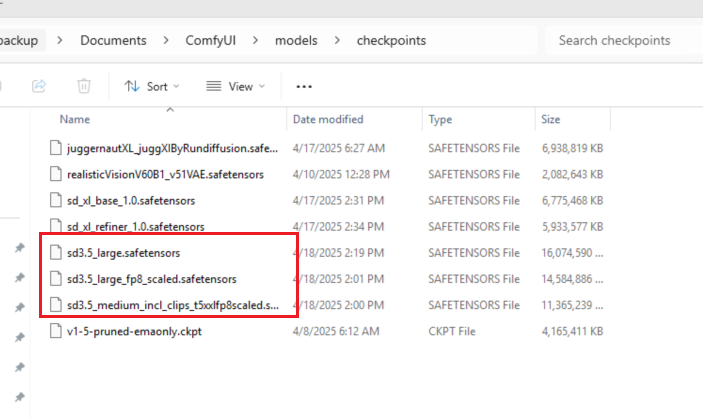
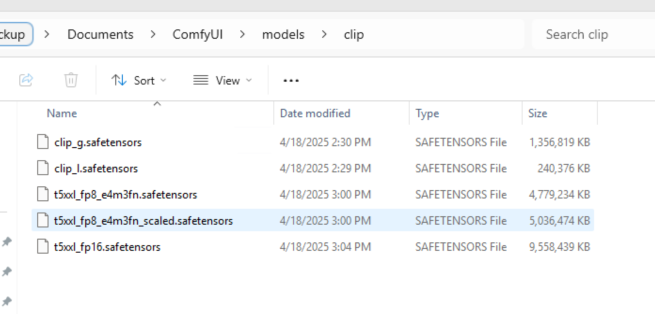
आवश्यक फ़ाइलें डाउनलोड करने के बाद, उन्हें अपनी ComfyUI निर्देशिका में इस प्रकार व्यवस्थित करें:
- चेकपॉइंट फ़ाइल:
sd3.5-large_fp8_scaled.safetensorsको/models/checkpoints/में रखें।
- टेक्स्ट एन्कोडर फ़ाइलें:
clip_g.safetensors,clip_l.safetensors, औरt5xxl_fp8_scaled.safetensorsको/models/clip/में रखें।
चरण 2: ComfyUI पुनः आरंभ करें
यह सुनिश्चित करने के लिए ComfyUI पुनः आरंभ करें कि नई जोड़ी गई फ़ाइलें सही ढंग से लोड हों।
छवि निर्माण के लिए वर्कफ़्लो
चरण 1: मॉडल और टेक्स्ट एन्कोडर लोड करना
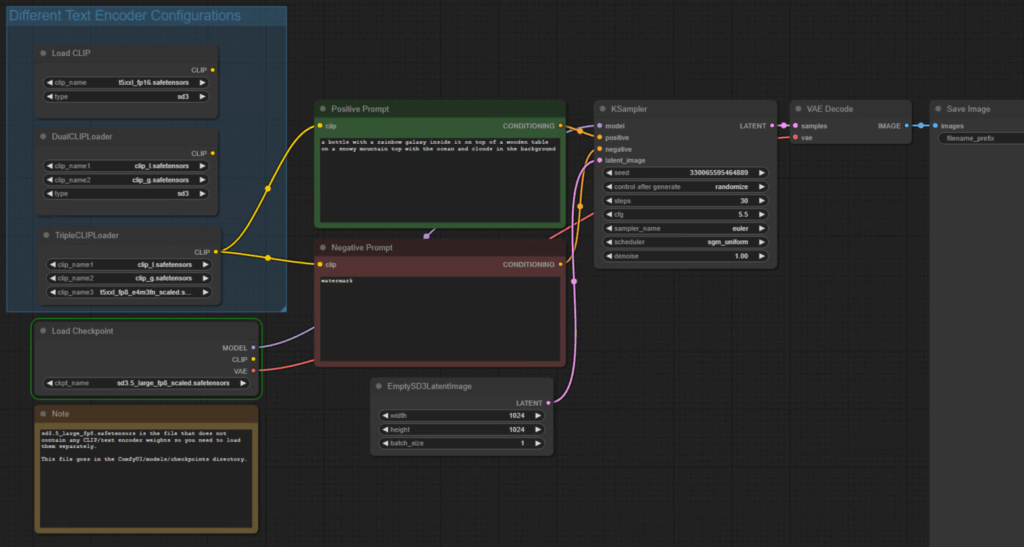
- ComfyUI खोलें और वेबसाइट से डाउनलोड किया गया वर्कफ़्लो लोड करें Comfy-Org/stable-diffusion-3.5-fp8 at main, और TripleCLIPLoader नोड बनाकर टेक्स्ट एन्कोडर लोड करें (डिफ़ॉल्ट रूप से लोडर पहले से मौजूद है):
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- टेक्स्ट एन्कोडर को सकारात्मक और नकारात्मक प्रॉम्प्ट इनपुट से कनेक्ट करें।
- Stable Diffusion 3.5 Large fp8 मॉडल (
sd3.5-large_fp8_scaled.safetensors) को चेकपॉइंट के रूप में लोड करें।
चरण 2: मॉडल सेटिंग समायोजित करना
Stable Diffusion 3.5 Large Turbo एक डिस्टिल्ड मॉडल है, जो गति के लिए अनुकूलित है। सर्वोत्तम परिणामों के लिए निम्नलिखित सेटिंग समायोजित करें:
- सैंपलिंग चरण: सैंपलिंग चरणों की संख्या 4 पर सेट करें ताकि गुणवत्ता बनाए रखते हुए निर्माण समय कम हो।
- CFG Scale: CFG (Classifier-Free Guidance) स्केल को 1 तक कम करें ताकि संतुलित छवि निर्माण हो।
चरण 3: छवियाँ बनाना
- विस्तृत प्रॉम्प्ट दर्ज करें, जो T5 एन्कोडर की उन्नत सिंटैक्स समझ का लाभ उठाता है।
उदाहरण:A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - Queue पर क्लिक करके प्रॉम्प्ट निष्पादित करें।
- ध्यान दें: मॉडल के बड़े आकार और एन्कोडर के कारण पहली छवि बनाने में कई मिनट लग सकते हैं। बाद की छवियाँ तेज़ी से बनेंगी।
Stable Diffusion 3.5 के लिए प्रमुख बातें
- प्रॉम्प्ट की लंबाई:
- T5 एन्कोडर अधिकतम 256 टोकन तक का समर्थन करता है, जिससे विस्तृत प्रॉम्प्ट का उपयोग संभव होता है।
- हालाँकि, CLIP एन्कोडर प्रॉम्प्ट को 75 टोकन तक सीमित करता है, जो जटिल विवरणों को बाधित कर सकता है।
- हार्डवेयर आवश्यकताएँ:
- हालाँकि Stable Diffusion 3.5 Large Turbo सीमित वीडियो RAM वाले सिस्टम के लिए अनुकूलित है, प्रारंभिक सेटअप में फिर भी काफी मेमोरी की आवश्यकता हो सकती है, विशेष रूप से T5 एन्कोडर के लिए।
- आउटपुट गुणवत्ता:
- मॉडल 1024×1024 रेज़ोल्यूशन में छवियाँ बनाता है, जिससे पेशेवर उपयोग के लिए उपयुक्त उच्च-गुणवत्ता वाले परिणाम मिलते हैं।
निष्कर्ष
Stable Diffusion 3.5 Large AI छवि निर्माण में एक महत्वपूर्ण कदम है, जो तेज़ प्रदर्शन और बेहतर प्रॉम्प्ट समझ प्रदान करता है। इस मार्गदर्शिका का पालन करके, उपयोगकर्ता ComfyUI के साथ मॉडल को प्रभावी ढंग से सेट कर सकते हैं और शानदार, उच्च-रिज़ॉल्यूशन छवियाँ बना सकते हैं। भविष्य के अपडेट में अपेक्षित अतिरिक्त सुधारों के साथ, Stable Diffusion 3.5 रचनाकारों और डेवलपर दोनों के लिए एक शक्तिशाली उपकरण है।