Stable Diffusion 3.5 est la dernière itération de la technologie de génération d'images par IA, offrant des performances améliorées, une meilleure compréhension des invites et une compatibilité avec les systèmes disposant d'une mémoire vidéo limitée. Grâce aux progrès réalisés dans l'architecture du modèle et les encodeurs de texte, cette version permet aux créateurs de produire rapidement et efficacement des images de haute qualité. Ce guide présente en détail Stable Diffusion 3.5 Large Turbo, y compris ses fonctionnalités, son processus de configuration et un flux de travail pratique avec ComfyUI.
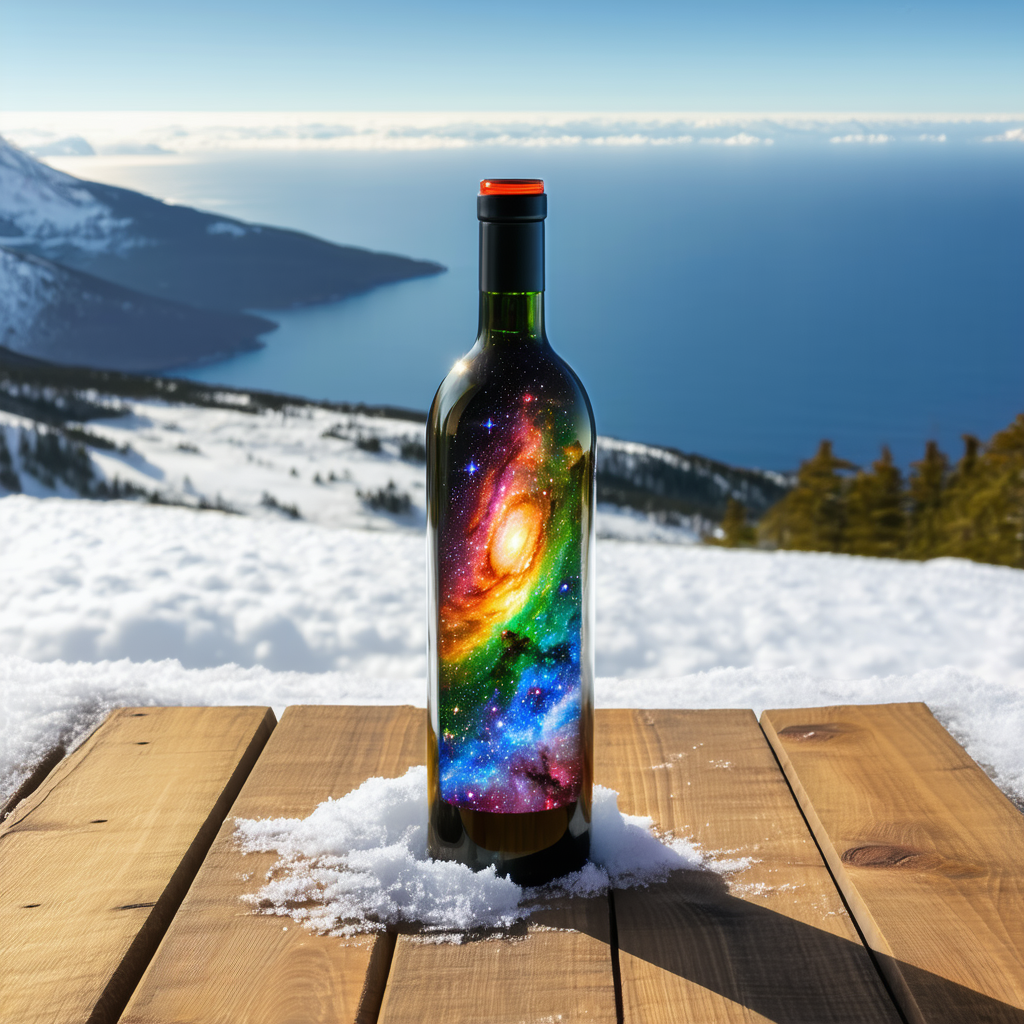
Table des matières
Qu'est-ce que Stable Diffusion 3.5 ?
Stable Diffusion est un modèle d'IA générative de pointe conçu pour la synthèse texte-image. La version 3.5 apporte plusieurs améliorations par rapport à ses prédécesseurs, notamment :
- Meilleure compréhension des invites:
L'intégration des encodeurs de texte T5 améliore la capacité du modèle à interpréter des invites complexes et les relations entre les éléments. Il devient ainsi plus facile de générer des images qui correspondent étroitement aux descriptions des utilisateurs. - Sorties en plus haute résolution:
Stable Diffusion 3.5 génère des images à une résolution native de 1024×1024, offrant des résultats plus propres et plus nets que les versions précédentes. - Optimisé pour la vitesse et les performances:
La désignation « Turbo » indique que ce modèle est optimisé pour une exécution plus rapide, même sur des systèmes disposant d'une mémoire GPU limitée. - Conception modulaire:
Contrairement aux versions antérieures, les encodeurs de texte (clip_g,clip_l, ett5xxl_fp8) ne sont pas inclus dans le fichier de point de contrôle principal. Cette approche modulaire permet aux utilisateurs de personnaliser leur configuration en fonction des contraintes matérielles.
Que signifient FP8 et FP16 ?
Lorsque l'on travaille avec des modèles d'IA comme Stable Diffusion 3.5, des termes comme FP8 et FP16 désignent la précision en virgule flottante, qui détermine la façon dont les nombres sont représentés et traités dans le modèle. Voici une brève explication :
- FP8 (virgule flottante 8 bits):
FP8 utilise 8 bits pour représenter les nombres. C'est un format très efficace qui réduit l'utilisation de la mémoire et les exigences de calcul. Bien que FP8 offre une précision inférieure à celle de FP16, il est idéal pour les modèles optimisés pour la vitesse et le matériel aux ressources limitées, comme Stable Diffusion 3.5 Large Turbo. Cela le rend particulièrement utile pour les systèmes disposant de moins de mémoire vidéo. - FP16 (virgule flottante 16 bits):
FP16 utilise 16 bits pour représenter les nombres, offrant une précision supérieure à celle de FP8. Bien que FP16 nécessite plus de mémoire et de puissance de calcul, il est souvent utilisé dans des situations où la précision numérique est essentielle, comme l'entraînement de grands modèles d'IA ou la génération de sorties très détaillées.
Dans le contexte de Stable Diffusion 3.5, l'encodeur de texte T5 XXL FP8 utilise la précision FP8 pour équilibrer performances et efficacité matérielle, ce qui le rend adapté à un large éventail d'appareils.
Mémoire GPU suggérée pour exécuter Stable Diffusion 3.5
Stable Diffusion 3.5 nécessite des quantités variables de mémoire GPU selon l'usage prévu, comme la résolution de l'image, la taille du lot et l'application ou non d'optimisations. Voici un bref résumé :
Résumé des exigences en mémoire GPU
- Minimum (8 Go):
- Fonctionne avec des optimisations poussées comme FP16 et xFormers.
- Convient à la génération d'images de plus basse résolution (par exemple 512×512) avec une taille de lot de 1.
- Limites : ne peut pas gérer les hautes résolutions (1024×1024) ni les pipelines complexes.
- Recommandé (12–16 Go):
- Idéal pour les résolutions standard (512×512 ou 768×768) et les fonctionnalités modérées (par exemple, l'inpainting, ControlNet).
- Prend en charge des tailles de lot de 1–2 et des résolutions plus élevées (jusqu'à 1024×1024).
- Exemples : NVIDIA RTX 3060 (12 Go), RTX 3080 (10–12 Go), RTX 4070 (12 Go).
- Optimal (16–24 Go):
- Pour générer des images haute résolution (1024×1024 ou plus), des fonctionnalités avancées et des tailles de lot plus importantes (4–8 images).
- Exemples : NVIDIA RTX 3090 (24 Go), RTX 4090 (24 Go).
- Professionnel (>24 Go):
- Pour les chercheurs ou les environnements de production nécessitant des résolutions très élevées (par exemple 2048×2048), un réglage fin ou l'entraînement de modèles.
- Exemples : NVIDIA A100 (40 Go), H100 (80 Go).
Où télécharger les fichiers de Stable Diffusion 3.5
Pour configurer Stable Diffusion 3.5 Large Turbo, vous devrez télécharger les fichiers requis depuis les dépôts Hugging Face. Voici les liens directs :
1. Stable Diffusion 3.5 Large Checkpoint
- Nom du fichier:
sd3.5-large_turbo.safetensors - Lien de téléchargement: Stable Diffusion 3.5 Large Turbo Checkpoint
2. Encodeurs de texte
- Clip G Encoder:
clip_g.safetensors- Lien de téléchargement: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- Lien de téléchargement: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- Lien de téléchargement: T5 XXL FP8 Encoder
Configuration du point de contrôle Stable Diffusion 3.5 Large
Étape 1 : Organiser les fichiers
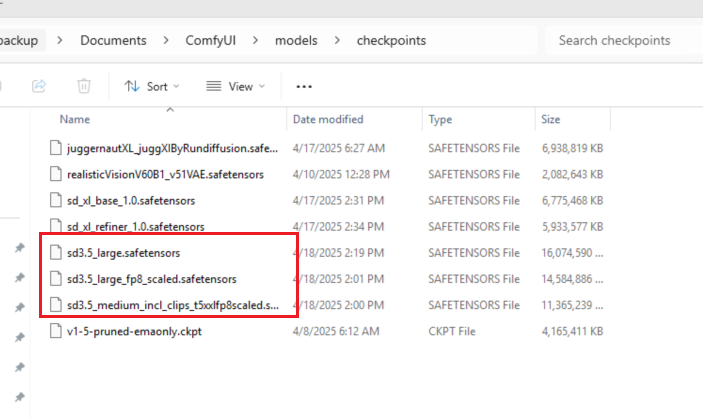
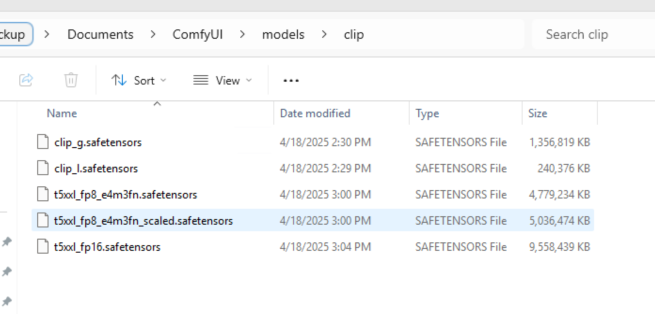
Après avoir téléchargé les fichiers requis, organisez-les dans votre répertoire ComfyUI comme suit :
- Fichier de point de contrôle:
Placezsd3.5-large_fp8_scaled.safetensorsdans/models/checkpoints/.
- Fichiers d'encodeurs de texte:
Placezclip_g.safetensors,clip_l.safetensors, ett5xxl_fp8_scaled.safetensorsdans/models/clip/.
Étape 2 : Redémarrer ComfyUI
Redémarrez ComfyUI pour vous assurer que les fichiers nouvellement ajoutés sont chargés correctement.
Flux de travail pour la génération d'images
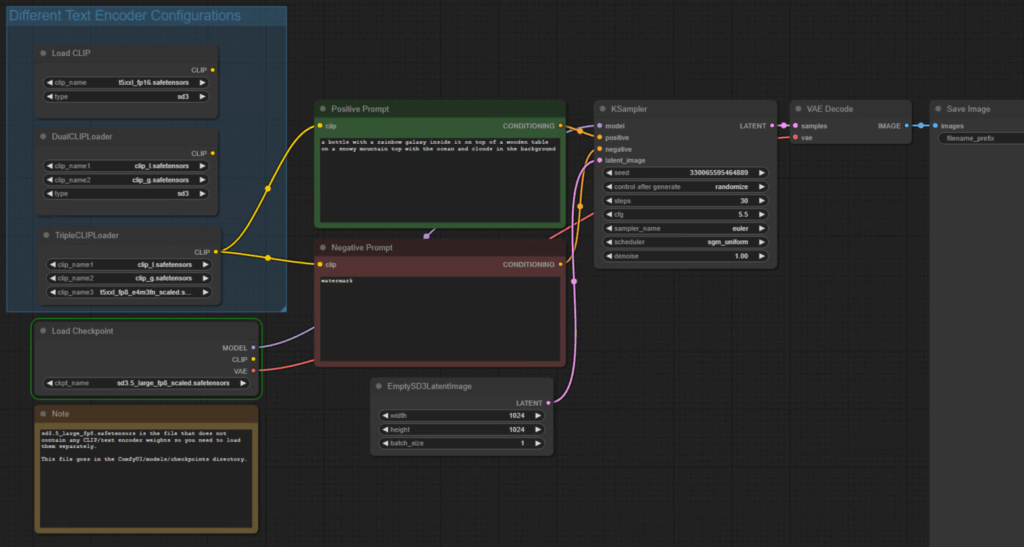
Étape 1 : Chargement du modèle et des encodeurs de texte
- Ouvrez ComfyUI et chargez le flux de travail téléchargé depuis le site web Comfy-Org/stable-diffusion-3.5-fp8 at main, puis créez un TripleCLIPLoader nœud pour charger les encodeurs de texte (par défaut, le chargeur existe déjà) :
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- Connectez les encodeurs de texte aux entrées d'invite positive et négative .
- Chargez le modèle Stable Diffusion 3.5 Large fp8 (
sd3.5-large_fp8_scaled.safetensors) comme point de contrôle.
Étape 2 : Ajuster les paramètres du modèle
Stable Diffusion 3.5 Large Turbo est un modèle distillé, optimisé pour la vitesse. Ajustez les paramètres suivants pour des résultats optimaux :
- Étapes d'échantillonnage: définissez le nombre d'étapes d'échantillonnage sur 4 pour réduire le temps de génération tout en préservant la qualité.
- CFG Scale: abaissez l'échelle CFG (Classifier-Free Guidance) à 1 pour une génération d'images équilibrée.
Étape 3 : Générer des images
- Saisissez une invite détaillée qui exploite la compréhension syntaxique avancée de l'encodeur T5.
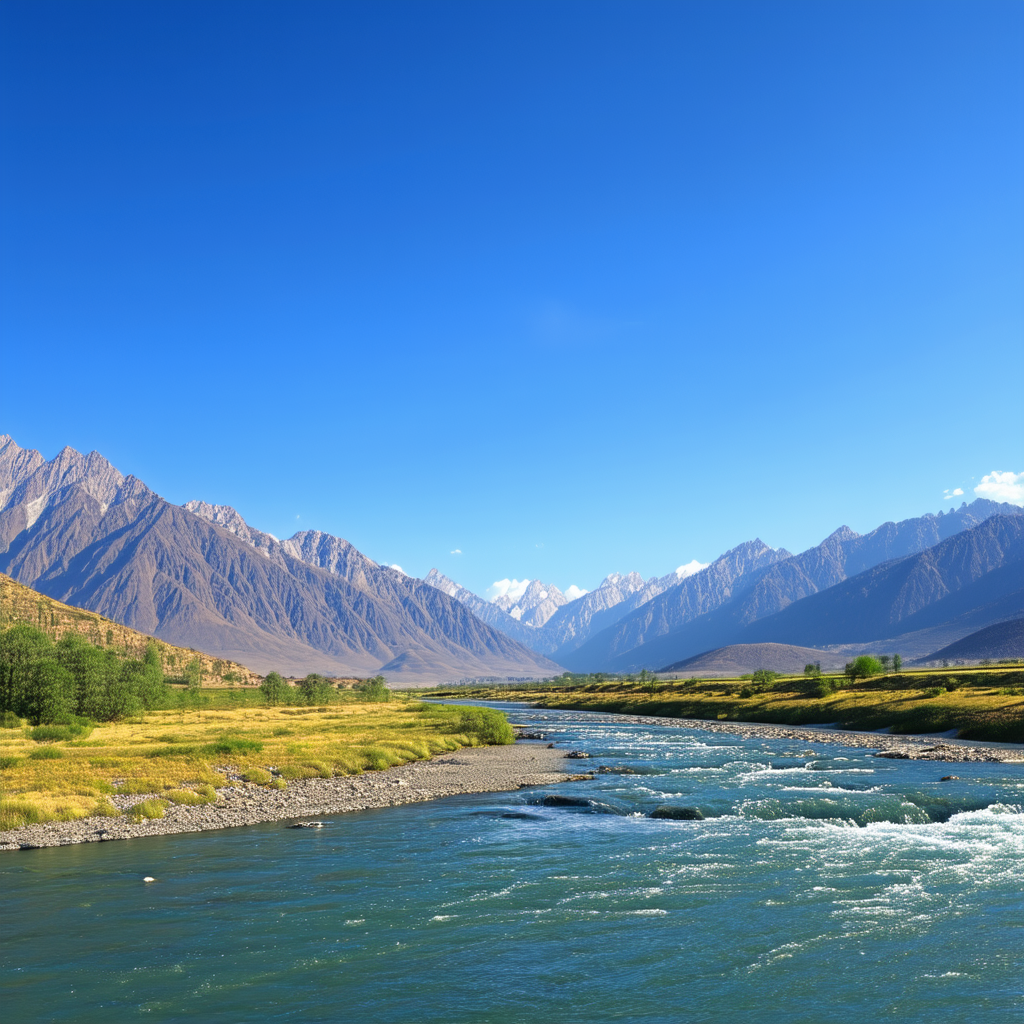
Exemple :A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - Cliquez sur Queue pour exécuter l'invite.
- Remarque: la première génération d'image peut prendre plusieurs minutes en raison de la grande taille du modèle et des encodeurs. Les générations suivantes seront plus rapides.
Considérations clés pour Stable Diffusion 3.5
- Longueur de l'invite:
- L'encodeur T5 prend en charge jusqu'à 256 jetons, ce qui permet des invites détaillées.
- Cependant, l'encodeur CLIP limite les invites à 75 jetons, ce qui peut contraindre les descriptions complexes.
- Exigences matérielles:
- Bien que Stable Diffusion 3.5 Large Turbo soit optimisé pour les systèmes disposant d'une mémoire vidéo limitée, la configuration initiale peut encore nécessiter une mémoire importante, en particulier pour l'encodeur T5.
- Qualité de sortie:
- Le modèle génère des images en résolution 1024×1024, offrant des résultats de haute qualité adaptés à un usage professionnel.
Conclusion
Stable Diffusion 3.5 Large représente une avancée significative dans la génération d'images par IA, offrant des performances plus rapides et une meilleure compréhension des invites. En suivant ce guide, les utilisateurs peuvent configurer et utiliser efficacement le modèle avec ComfyUI pour produire des images époustouflantes en haute résolution. Avec des améliorations supplémentaires attendues dans les futures mises à jour, Stable Diffusion 3.5 est un outil puissant pour les créateurs comme pour les développeurs.