O Stable Diffusion 3.5 é a iteração mais recente da tecnologia de geração de imagens por IA, oferecendo desempenho aprimorado, melhor compreensão de prompts e compatibilidade com sistemas com pouca VRAM. Com os avanços na arquitetura do modelo e nos codificadores de texto, esta versão permite que os criadores produzam imagens de alta qualidade de forma rápida e eficiente. Este guia oferece uma visão detalhada do Stable Diffusion 3.5 Large Turbo, incluindo seus recursos, o processo de configuração e um fluxo de trabalho prático com o ComfyUI.
Índice
O que é Stable Diffusion 3.5?
O Stable Diffusion é um modelo de IA generativa de ponta projetado para síntese de texto para imagem. A versão 3.5 introduz várias melhorias em relação às suas antecessoras, incluindo:
- Compreensão aprimorada de prompts:
A integração dos codificadores de texto T5 melhora a capacidade do modelo de interpretar prompts complexos e as relações entre os elementos. Isso facilita a geração de imagens que se alinham de perto com as descrições do usuário. - Saídas de maior resolução:
O Stable Diffusion 3.5 gera imagens com uma resolução nativa de 1024×1024, oferecendo resultados mais limpos e nítidos em comparação com as versões anteriores. - Otimizado para velocidade e desempenho:
A designação «Turbo» indica que este modelo é otimizado para execução mais rápida, mesmo em sistemas com pouca memória GPU. - Design modular:
Ao contrário das versões anteriores, os codificadores de texto (clip_g,clip_l, et5xxl_fp8) não estão incluídos no arquivo de checkpoint principal. Essa abordagem modular permite que os usuários personalizem sua configuração com base nas limitações de hardware.
O que significam FP8 e FP16?
Ao trabalhar com modelos de IA como o Stable Diffusion 3.5, termos como FP8 e FP16 referem-se à precisão de ponto flutuante, que determina como os números são representados e processados no modelo. Aqui está uma explicação rápida:
- FP8 (ponto flutuante de 8 bits):
O FP8 usa 8 bits para representar números. É um formato altamente eficiente que reduz o uso de memória e os requisitos computacionais. Embora o FP8 ofereça menor precisão em comparação com o FP16, ele é ideal para modelos otimizados para velocidade e hardware com recursos limitados, como o Stable Diffusion 3.5 Large Turbo. Isso o torna particularmente útil para sistemas com pouca VRAM. - FP16 (ponto flutuante de 16 bits):
O FP16 usa 16 bits para representar números, proporcionando maior precisão do que o FP8. Embora o FP16 exija mais memória e poder computacional, ele é frequentemente usado em situações em que a precisão numérica é crítica, como o treinamento de grandes modelos de IA ou a geração de saídas altamente detalhadas.
No contexto do Stable Diffusion 3.5, o codificador de texto T5 XXL FP8 utiliza a precisão FP8 para equilibrar desempenho e eficiência de hardware, tornando-o adequado para uma ampla gama de dispositivos.
Memória GPU sugerida para executar o Stable Diffusion 3.5
O Stable Diffusion 3.5 requer quantidades variadas de memória GPU dependendo do uso pretendido, como resolução da imagem, tamanho do lote e se otimizações são aplicadas. Aqui está um resumo rápido:
Resumo dos requisitos de memória GPU
- Mínimo (8 GB):
- Funciona com otimizações intensivas como FP16 e xFormers.
- Adequado para gerar imagens de menor resolução (por exemplo, 512×512) com tamanho de lote 1.
- Limitações: não consegue lidar com altas resoluções (1024×1024) ou pipelines complexos.
- Recomendado (12–16 GB):
- Ideal para resoluções padrão (512×512 ou 768×768) e recursos moderados (por exemplo, inpainting, ControlNet).
- Suporta tamanhos de lote de 1–2 e resoluções mais altas (até 1024×1024).
- Exemplos: NVIDIA RTX 3060 (12 GB), RTX 3080 (10–12 GB), RTX 4070 (12 GB).
- Ideal (16–24 GB):
- Para gerar imagens de alta resolução (1024×1024 ou mais), recursos avançados e tamanhos de lote maiores (4–8 imagens).
- Exemplos: NVIDIA RTX 3090 (24 GB), RTX 4090 (24 GB).
- Profissional (>24 GB):
- Para pesquisadores ou ambientes de produção que exigem resoluções muito altas (por exemplo, 2048×2048), ajuste fino ou treinamento de modelos.
- Exemplos: NVIDIA A100 (40 GB), H100 (80 GB).
Onde baixar os arquivos do Stable Diffusion 3.5
Para configurar o Stable Diffusion 3.5 Large Turbo, você precisará baixar os arquivos necessários dos repositórios do Hugging Face. Abaixo estão os links diretos:
1. Stable Diffusion 3.5 Large Checkpoint
- Nome do arquivo:
sd3.5-large_turbo.safetensors - Link de download: Stable Diffusion 3.5 Large Turbo Checkpoint
2. Codificadores de texto
- Clip G Encoder:
clip_g.safetensors- Link de download: Clip G Encoder
- Clip L Encoder:
clip_l.safetensors- Link de download: Clip L Encoder
- T5 XXL Encoder (FP8):
t5xxl_fp8.safetensors- Link de download: T5 XXL FP8 Encoder
Configuração do checkpoint Stable Diffusion 3.5 Large
Passo 1: Organizar os arquivos
Após baixar os arquivos necessários, organize-os no seu diretório do ComfyUI da seguinte forma:
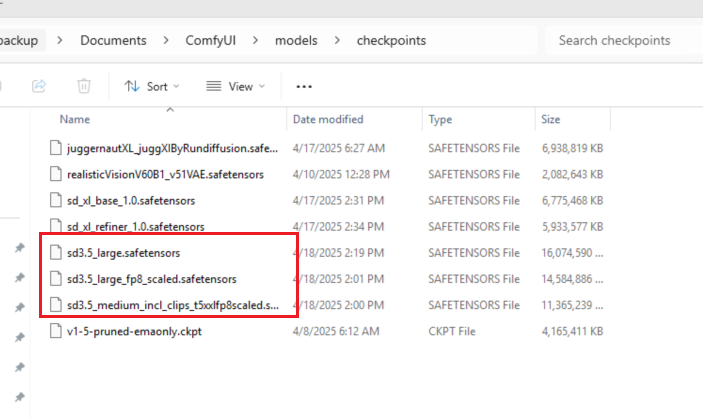
- Arquivo de checkpoint:
Coloquesd3.5-large_fp8_scaled.safetensorsem/models/checkpoints/.
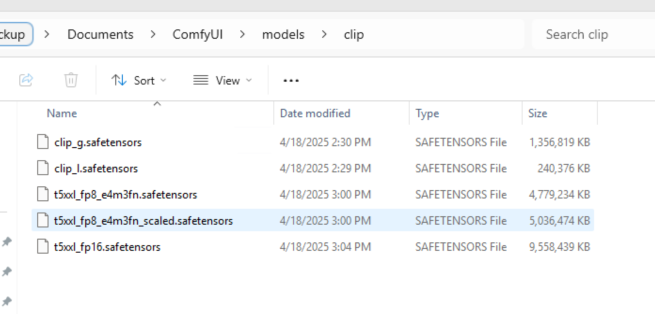
- Arquivos de codificadores de texto:
Coloqueclip_g.safetensors,clip_l.safetensors, et5xxl_fp8_scaled.safetensorsem/models/clip/.
Passo 2: Reiniciar o ComfyUI
Reinicie o ComfyUI para garantir que os arquivos recém-adicionados sejam carregados corretamente.
Fluxo de trabalho para geração de imagens
Passo 1: Carregar o modelo e os codificadores de texto
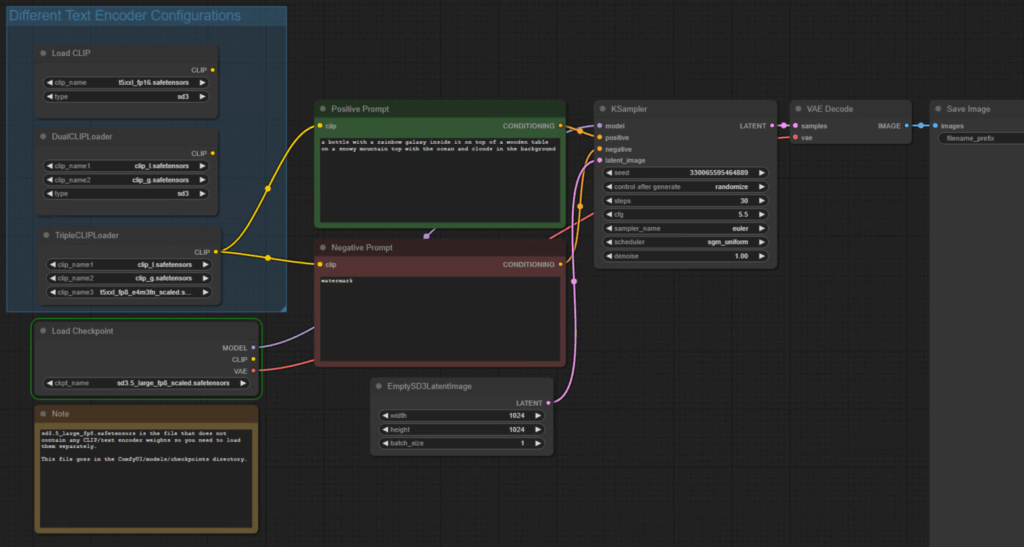
- Abra o ComfyUI e carregue o fluxo de trabalho baixado do site Comfy-Org/stable-diffusion-3.5-fp8 at main, e crie um TripleCLIPLoader nó para carregar os codificadores de texto (por padrão, o carregador já existe):
clip_g.safetensorsclip_l.safetensorst5xxl_fp8_e4m3fn_scaled.safetensors
- Conecte os codificadores de texto às entradas de prompt positivo e negativo .
- Carregue o modelo Stable Diffusion 3.5 Large fp8 (
sd3.5-large_fp8_scaled.safetensors) como checkpoint.
Passo 2: Ajustar as configurações do modelo
O Stable Diffusion 3.5 Large Turbo é um modelo destilado, otimizado para velocidade. Ajuste as seguintes configurações para obter os melhores resultados:
- Etapas de amostragem: defina o número de etapas de amostragem para 4 para reduzir o tempo de geração mantendo a qualidade.
- CFG Scale: reduza a escala CFG (Classifier-Free Guidance) para 1 para uma geração de imagens equilibrada.
Passo 3: Gerar imagens
- Insira um prompt detalhado que aproveita a compreensão sintática avançada do codificador T5.
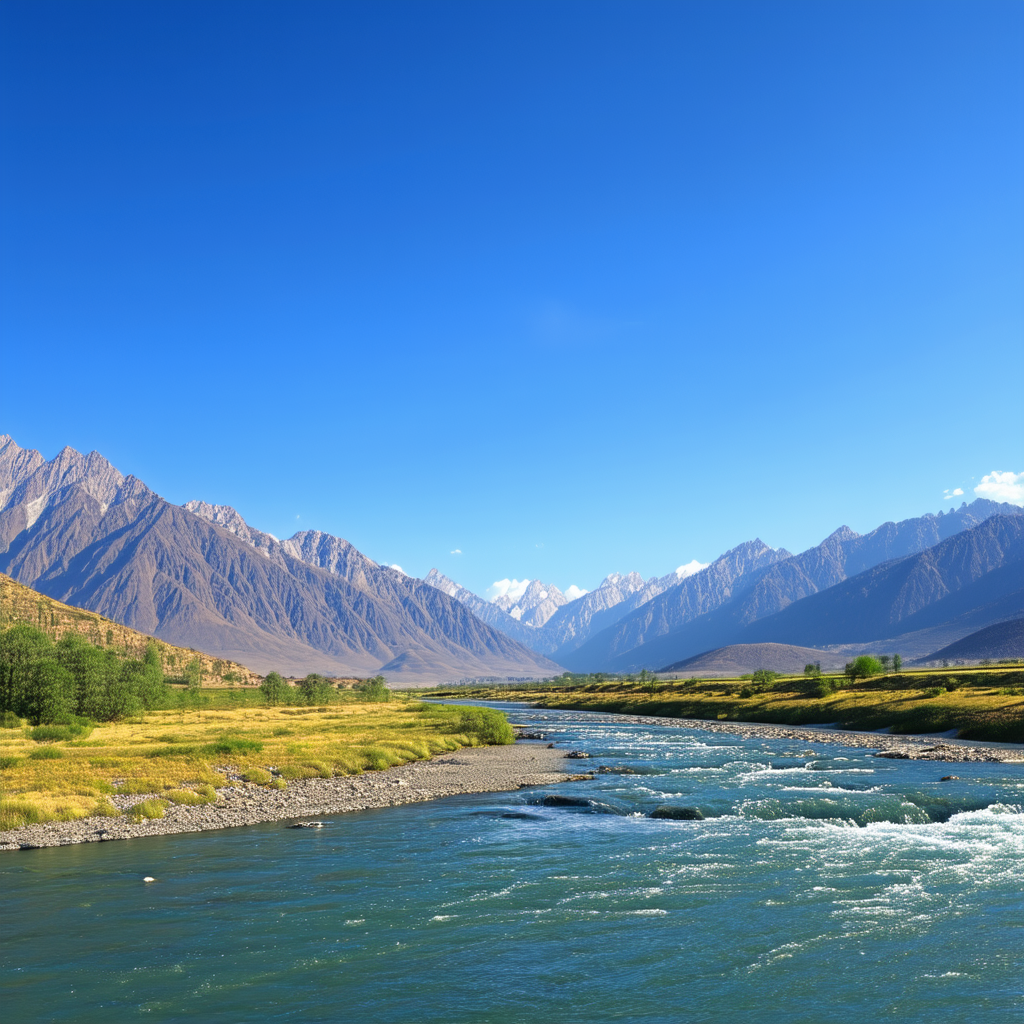
Exemplo:A serene landscape with mountains in the background, a clear blue sky, and a flowing river, photorealistic, high detail. - Clique em Queue para executar o prompt.
- Nota: a primeira geração de imagens pode levar vários minutos devido ao grande tamanho do modelo e aos codificadores. As gerações subsequentes serão mais rápidas.
Considerações importantes sobre o Stable Diffusion 3.5
- Comprimento do prompt:
- O codificador T5 suporta até 256 tokens, permitindo prompts detalhados.
- No entanto, o codificador CLIP limita os prompts a 75 tokens, o que pode restringir descrições complexas.
- Requisitos de hardware:
- Embora o Stable Diffusion 3.5 Large Turbo seja otimizado para sistemas com pouca VRAM, a configuração inicial ainda pode exigir uma quantidade significativa de memória, especialmente para o codificador T5.
- Qualidade de saída:
- O modelo gera imagens com resolução de 1024×1024, proporcionando resultados de alta qualidade adequados para uso profissional.
Conclusão
O Stable Diffusion 3.5 Large representa um grande avanço na geração de imagens por IA, oferecendo desempenho mais rápido e melhor compreensão de prompts. Seguindo este guia, os usuários podem configurar e usar o modelo com eficácia com o ComfyUI para produzir imagens impressionantes de alta resolução. Com refinamentos adicionais esperados em atualizações futuras, o Stable Diffusion 3.5 é uma ferramenta poderosa tanto para criadores quanto para desenvolvedores.