이전에는 Azure AI Foundry /blogs/deploy-azure-openai-gpt-4o-and-integrate-with-nextchat-or-chatbox-clients-build-your-personal-ai-companion/, /blogs/deploying-deepseek-r1-on-azure-ai-foundry-chatbox-integration/를 통해 LLM을 배포하는 방법을 배웠습니다. 그렇다면 LLM용 사용자 지정 콘텐츠 필터는 어떻게 만들까요?
생성형 AI 모델의 안전하고 규정을 준수하는 사용을 보장하는 것은 윤리적인 AI 애플리케이션에 매우 중요합니다. Azure AI 콘텐츠 필터링을 사용하면 기본 필터를 활용하거나 사용자 지정 구성을 만들어 유해한 콘텐츠를 효과적으로 조정할 수 있습니다. 이 글에서는 Azure AI Foundry에서 사용자 지정 콘텐츠 필터를 만들고 적용하는 방법에 대한 자세한 가이드를 제공하여 사용자가 콘텐츠 안전 조치를 필요에 맞게 조정할 수 있게 합니다.
목차
1. 콘텐츠 필터링 작동 방식
Azure AI Foundry는 Azure AI Content Safety를 통합하여 입력 프롬프트와 출력 완성 모두에서 유해한 콘텐츠를 분류하고 필터링합니다. 필터링 시스템은 고급 분류 모델을 사용하여 다음 카테고리의 유해한 콘텐츠를 탐지합니다.
- 증오: 정체성 집단을 겨냥한 차별적이거나 경멸적인 언어.
- 성적: 해부학, 성행위, 포르노그래피 또는 학대와 관련된 콘텐츠.
- 폭력: 신체적 해악, 무기 또는 폭력 행위에 대한 설명.
- 자해: 자해나 자살을 조장하거나 설명하는 콘텐츠.
각 카테고리는 심각도 수준에 따라 필터링됩니다.
- 안전: 전문적 또는 언론적 맥락.
- 낮음: 불쾌하거나 고정관념적인 언어.
- 중간: 모욕적이거나 위협적인 언어.
- 높음: 명시적인 유해 지침 또는 극단적인 해악.
기본적으로 Azure AI Foundry는 서버리스 API에 콘텐츠 필터링을 자동으로 적용하지만, 사용자는 더 엄격하거나 더 관대한 구성을 위해 사용자 지정 필터를 만들 수 있습니다.
2. 언어 지원
Azure AI 콘텐츠 필터링 모델은 다음을 포함한 주요 언어로 학습되었습니다.
- 영어
- 독일어
- 일본어
- 스페인어
- 프랑스어
- 이탈리아어
- 포르투갈어
- 중국어
시스템은 다른 언어에서도 동작할 수 있지만, 유해한 콘텐츠 탐지의 효과와 정확성을 보장하려면 테스트하는 것이 좋습니다.
3. 필터 유형
Azure AI Foundry는 두 가지 주요 필터 유형을 제공합니다.
입력 필터
모델에서 처리하기 전에 사용자 프롬프트에 적용됩니다.
출력 필터
모델에서 생성한 완성에 적용됩니다.
특수 필터는 다음과 같습니다.
- 탈옥 공격: 모델 보호 조치를 우회하도록 설계된 프롬프트를 방지합니다.
- 간접 공격: 외부 문서에 포함된 악의적인 지침을 탐지합니다.
- 보호된 자료 탐지: 저작권이 있거나 보호되는 텍스트/코드를 필터링합니다.
- 근거 탐지: 응답이 검증된 원본 자료를 기반으로 하는지 확인합니다.
4. 사용자 지정 콘텐츠 필터를 만드는 단계
Azure AI Foundry 포털에서 사용자 지정 콘텐츠 필터를 만들려면 다음 단계를 따르세요.
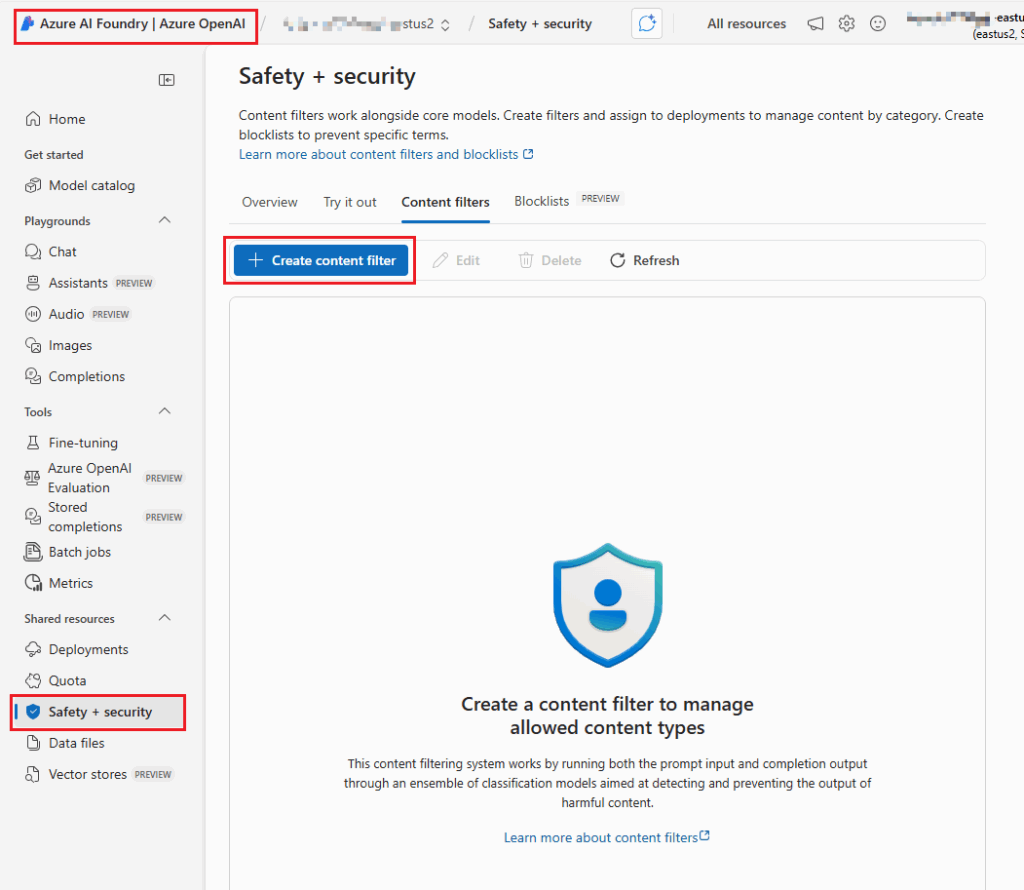
- 콘텐츠 필터로 이동
- 포털에서 안전 + 보안 >> 콘텐츠 필터로 이동합니다.
- 「+ 콘텐츠 필터 만들기」를 클릭하고 필터 이름과 같은 기본 정보를 입력합니다.
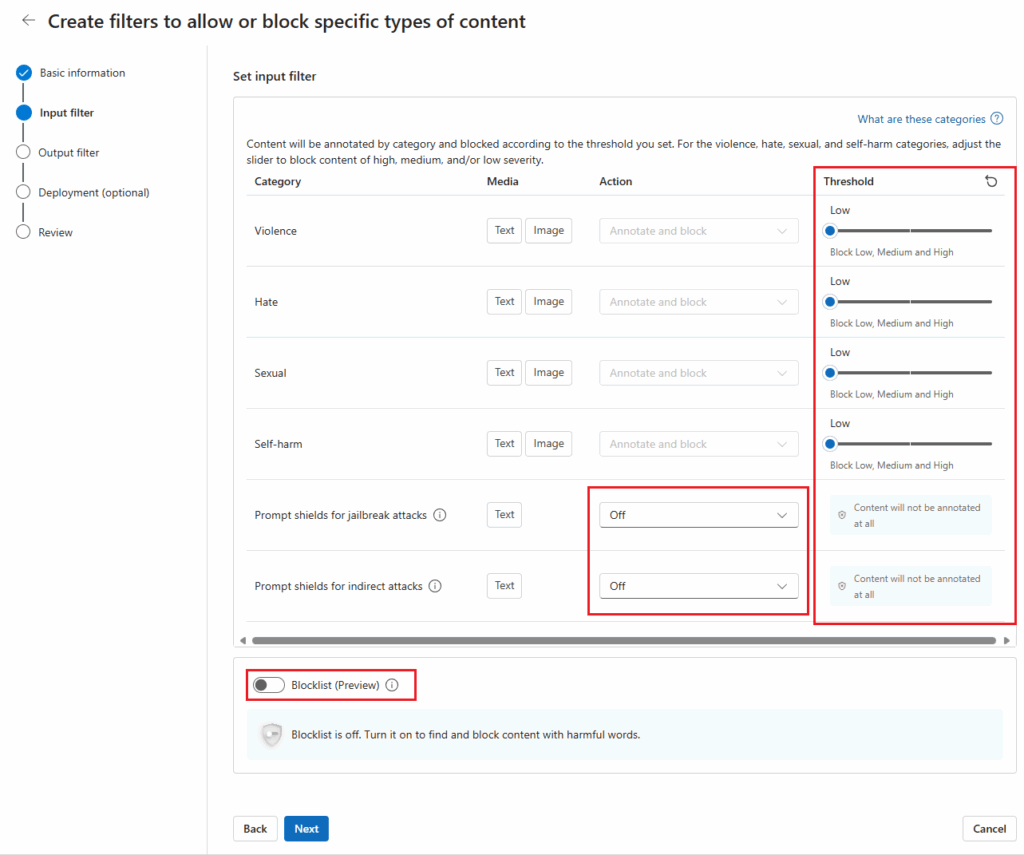
- 입력 필터 구성
- 콘텐츠 카테고리(예: 증오, 성적, 폭력)에 대한 심각도 임계값을 조정합니다.
- 다음과 같은 추가 기능을 활성화합니다. 프롬프트 쉴드또는 보호된 자료 탐지를 사용하여 특정 콘텐츠에 주석을 달거나 차단합니다.
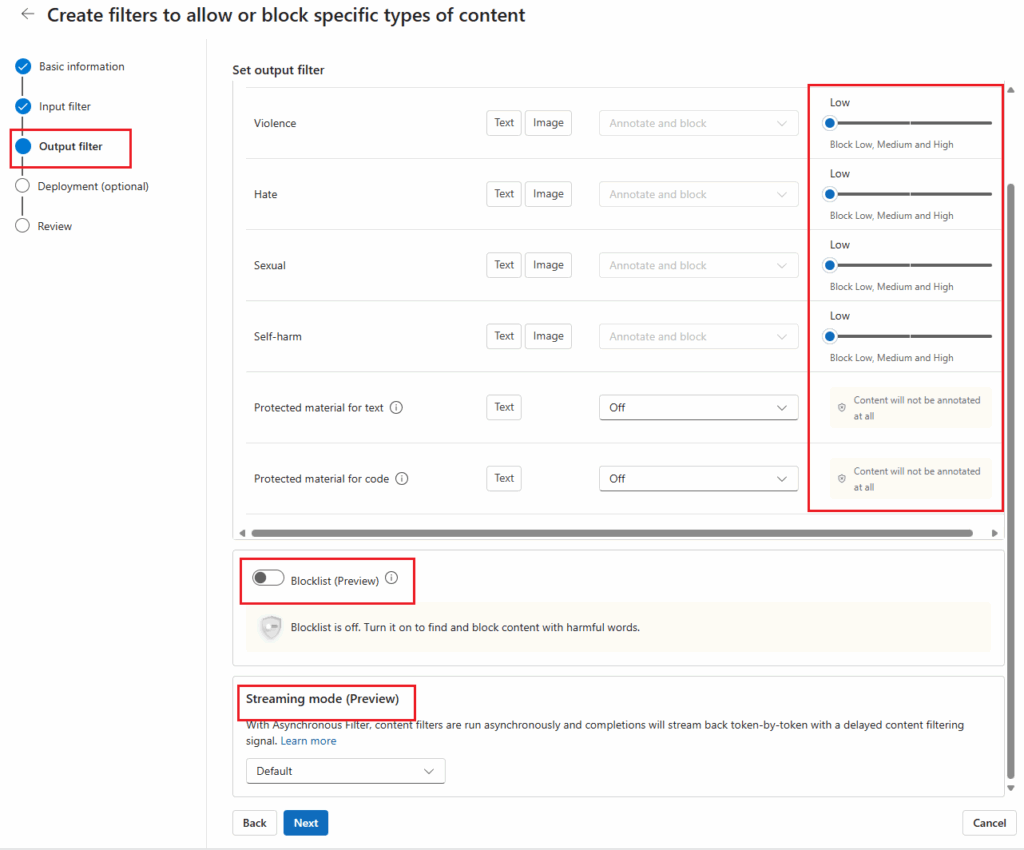
- 출력 필터 구성
- 출력 카테고리에 대한 심각도 임계값을 조정합니다.
- 실시간 필터링을 위해 스트리밍 모드를 활성화합니다.
- 원활한 통합을 위해 필요에 따라 필터를 배포와 연결합니다.
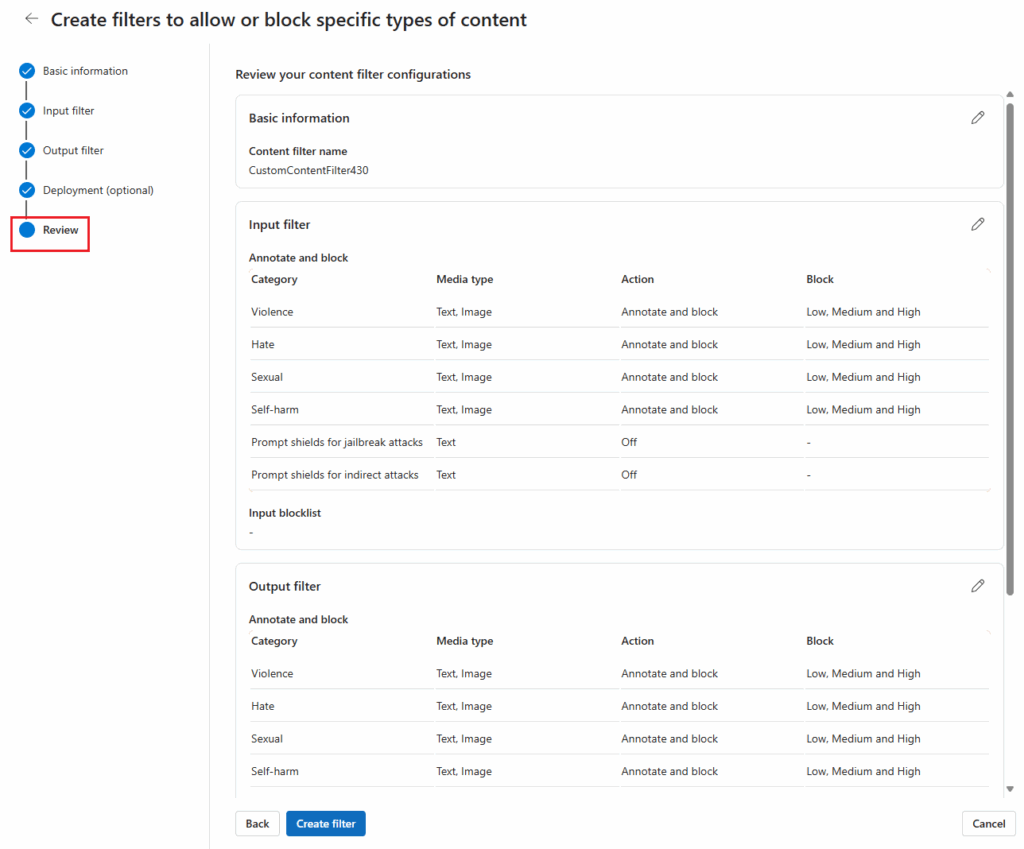
- 검토 및 만들기
- 설정을 다시 확인하고 필터 만들기를 선택하여 구성을 완료합니다.
5. 콘텐츠 필터 적용
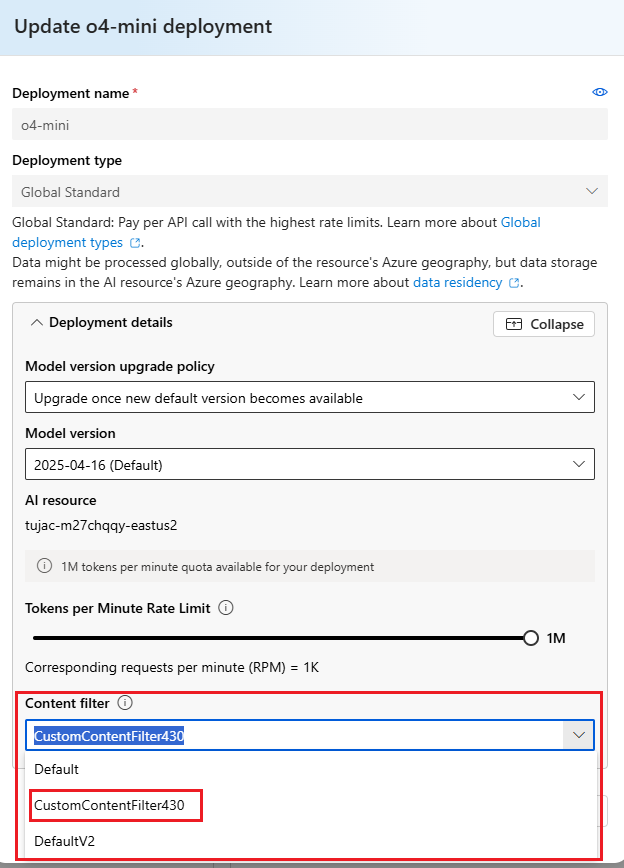
필터가 생성되면 배포에 적용할 수 있습니다.
- 모델 + 엔드포인트로 이동
- 포털에서 원하는 배포를 선택하고 편집.
- 콘텐츠 필터 할당
- 적절한 콘텐츠 필터를 선택하고 변경 내용을 저장합니다.
6. 구성 가능성 옵션(미리 보기)
Azure AI Foundry는 기본 및 사용자 지정 필터링 구성을 모두 제공합니다.
기본 구성
- GPT 모델: 모든 카테고리에서 중간 및 높은 심각도의 콘텐츠를 필터링합니다.
- DALL-E 모델: 프롬프트와 완성 모두에 대해 낮음, 중간, 높음 심각도의 콘텐츠를 필터링합니다.
사용자 지정 구성
사용자는 프롬프트와 완성에 대한 심각도 임계값을 개별적으로 조정할 수 있습니다.
- 엄격한 필터링: 낮음, 중간, 높음 심각도의 콘텐츠를 필터링합니다.
- 보통 필터링: 중간 및 높은 심각도의 콘텐츠를 필터링합니다.
- 최소 필터링: 높은 심각도의 콘텐츠만 필터링합니다(승인 필요).
- 필터링 없음: 필터링을 완전히 비활성화합니다(승인 필요).
7. 차단 목록 사용
차단 목록을 사용하여 입력 및 출력 필터링을 강화할 수 있습니다. 옵션은 다음과 같습니다.
- 욕설 차단 목록: 불쾌한 언어를 차단하기 위한 미리 정의된 목록.
- 사용자 지정 차단 목록: 특정 요구 사항에 맞춘 사용자 정의 목록.
8. 테스트 및 API 통합
필터를 적용한 후 Azure AI Foundry 플레이그라운드를 사용하여 기능을 테스트하세요. 고급 통합을 위해 REST API를 사용하여 프로그래밍 방식으로 필터를 관리할 수도 있습니다.
중요 참고 사항
- Whisper 모델: 콘텐츠 필터링은 Whisper 모델에서 처리하는 프롬프트와 완성에는 적용되지 않습니다.
- 수정된 필터에 대한 승인: 고객은 필터링 비활성화나 높은 심각도 필터링만 활성화와 같은 수정된 필터를 사용하려면 승인을 신청해야 합니다.
- 규정 준수 책임: 사용자는 Azure OpenAI를 통합할 때 Azure 행동 강령을 준수할 책임이 있습니다.
결론
Azure AI Foundry의 콘텐츠 필터링은 생성형 AI 모델의 안전하고 윤리적인 사용을 보장하는 강력한 도구입니다. 기본 필터를 활용하거나 사용자 지정 구성을 만들면 사용자는 특정 애플리케이션 요구 사항에 맞게 시스템을 조정할 수 있습니다. 유해한 프롬프트로부터 보호하든 규정을 준수하는 출력을 보장하든, Azure AI 콘텐츠 필터링은 콘텐츠 조정에서 높은 기준을 유지할 수 있는 유연성과 안정성을 제공합니다.
자세한 내용은 Azure AI Content Safety 설명서.